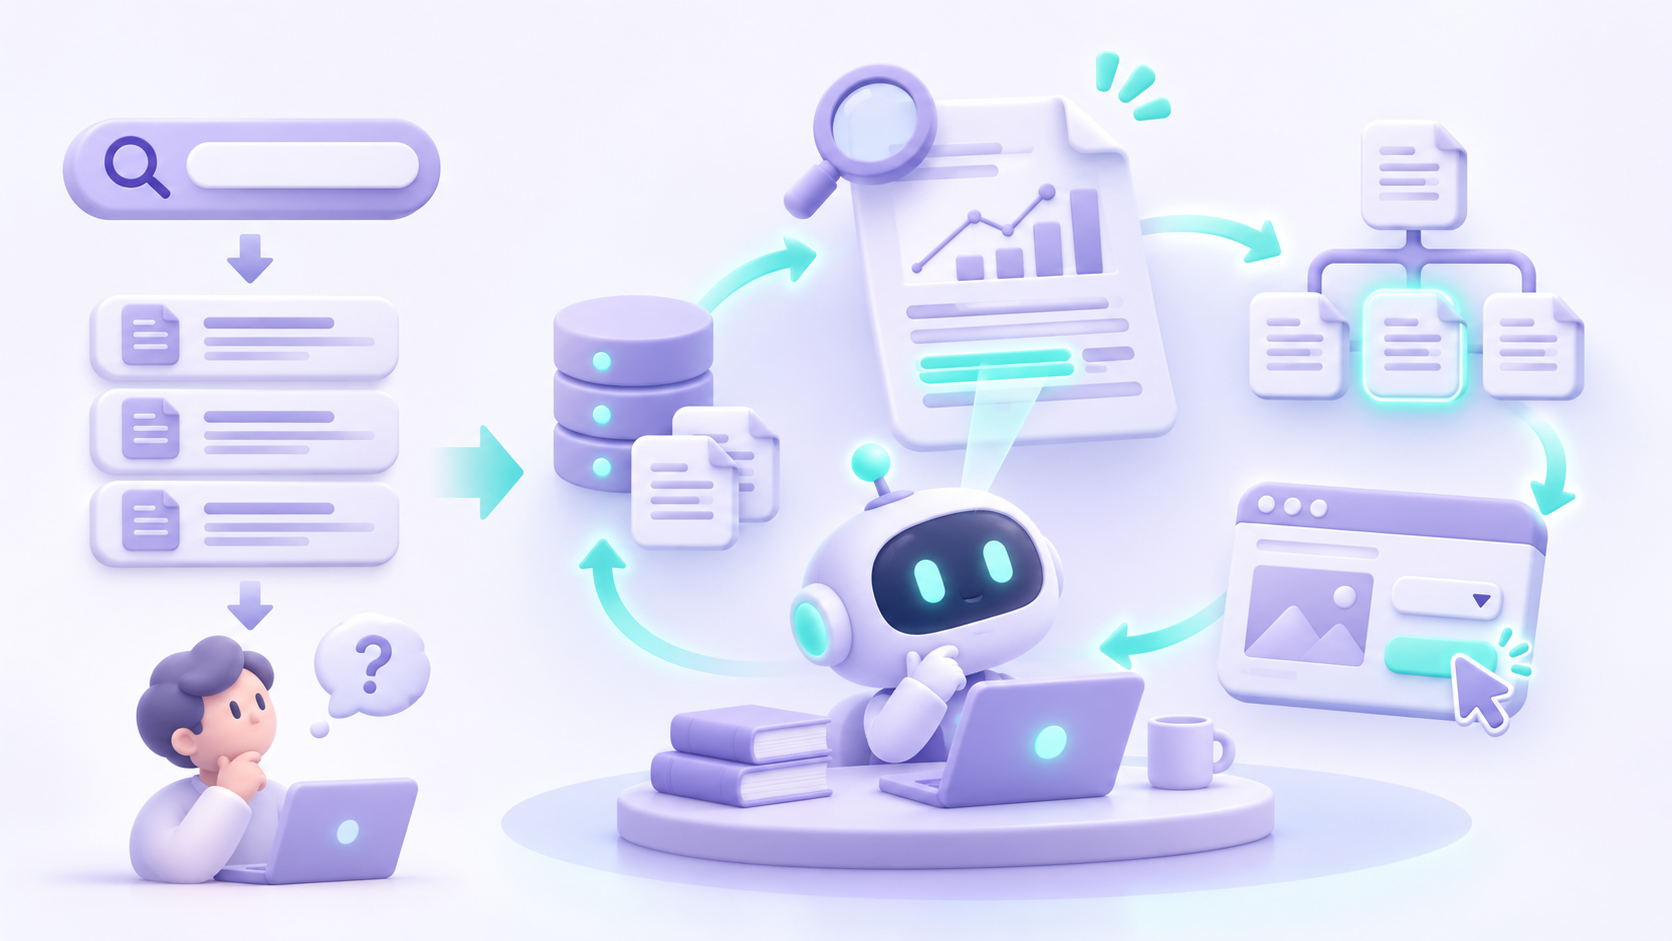
AI가 검색하는 시대, 검색 인터페이스가 바뀌고 있다
AI 에이전트가 검색을 수행하는 시대, 검색은 단순히 관련 문서를 찾는 일을 넘어 탐색 과정 전반을 지원하는 역할로 확장되고 있습니다. DCI, IndexAct, Web$hell, Self-Index를 통해 원문 탐색부터 검색 후보 관리, 웹에서의 행동, 스스로 발전하는 인덱스까지 검색 환경이 어떻게 진화하고 있는지 살펴봅니다.
AI 에이전트가 검색을 수행하는 시대, 검색은 단순히 관련 문서를 찾는 일을 넘어 탐색 과정 전반을 지원하는 역할로 확장되고 있습니다. DCI, IndexAct, Web$hell, Self-Index를 통해 원문 탐색부터 검색 후보 관리, 웹에서의 행동, 스스로 발전하는 인덱스까지 검색 환경이 어떻게 진화하고 있는지 살펴봅니다.

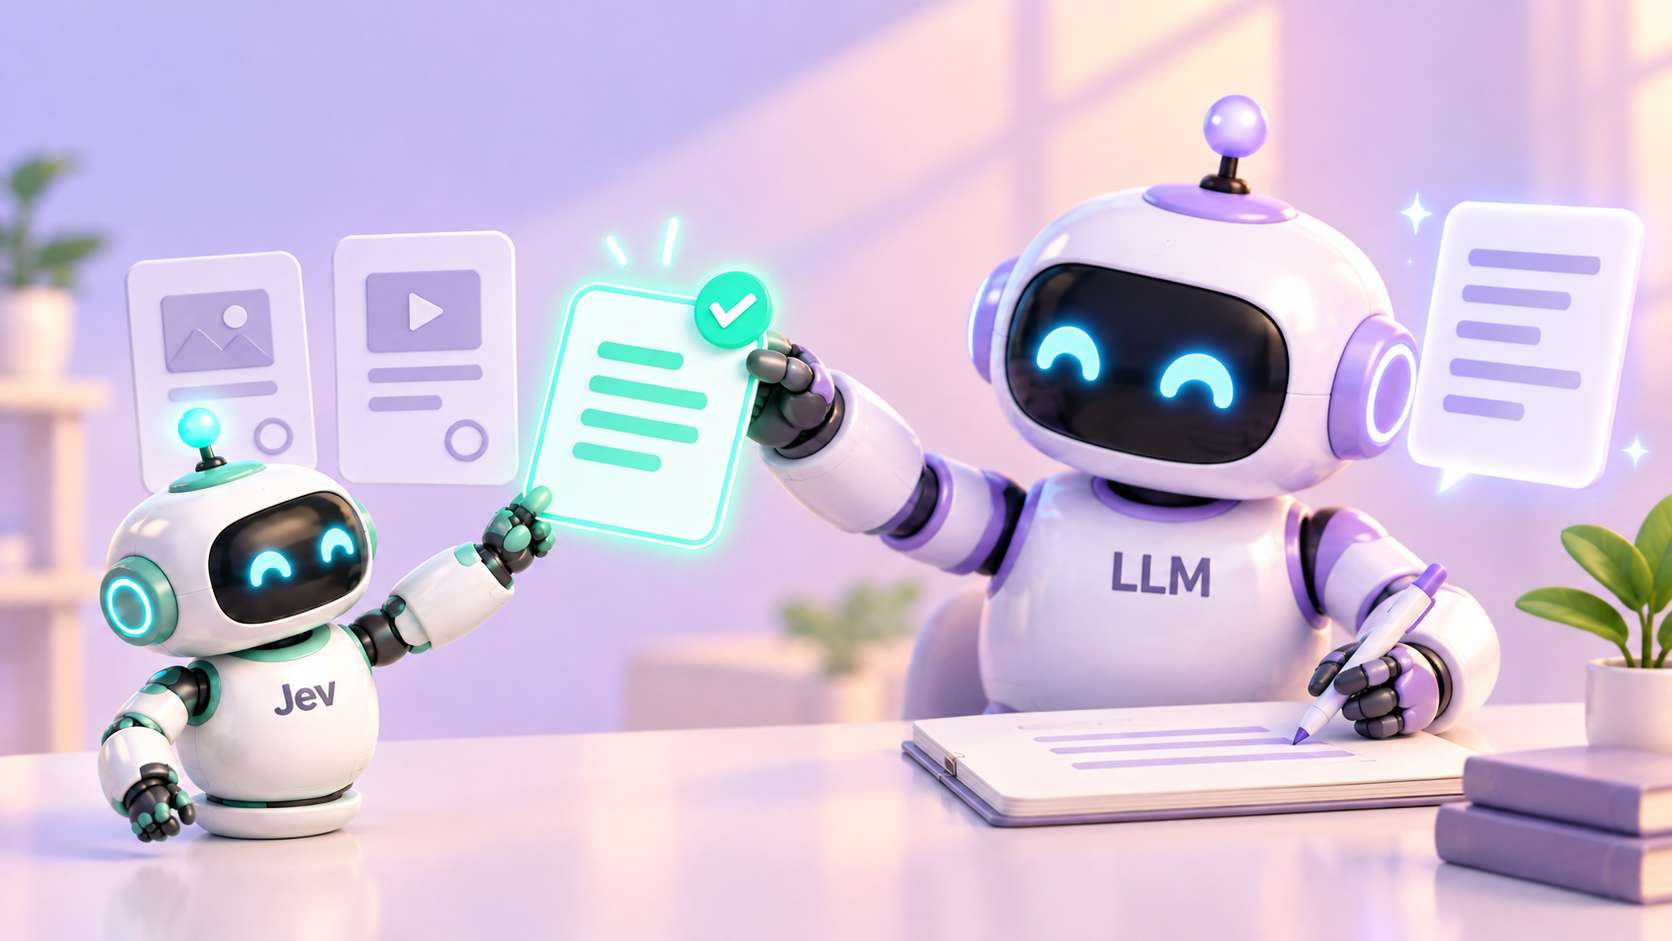
Jev의 등장은 AI 에이전트 설계에서 모델의 답변 능력뿐 아니라, 중간 판단을 어디에 맡기고 어떻게 연결할지도 중요함을 보여줍니다. SearchJev와 실제 활용 사례를 살펴보고, 빠른 선택·평가와 LLM의 계획·추론을 나누어 맡기는 방식이 전체 작업의 품질과 효율을 어떻게 바꿀 수 있는지 짚어봅니다.


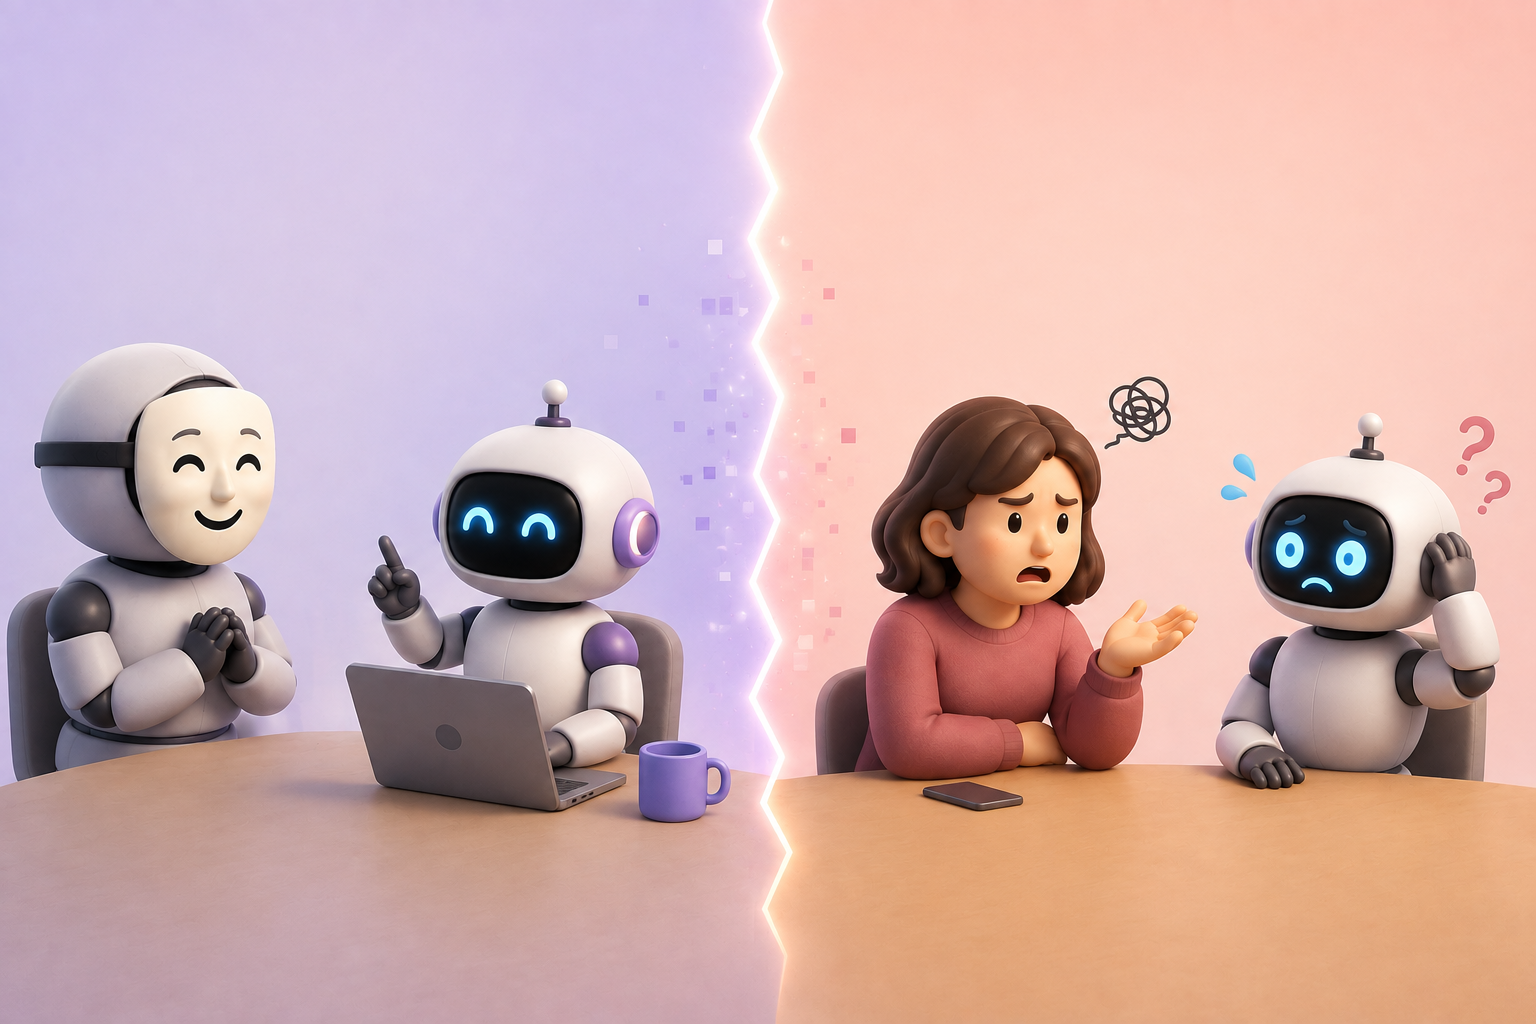
AI 에이전트의 벤치마크 점수, 실제 사람 앞에서도 그대로일까요? 에이전트를 훈련하고 채점하는 '사용자'는 대부분 LLM이 연기하는 가짜 사용자이고, 이들은 실제 사람보다 지나치게 협조적이고 균일해서 성능을 부풀리고 격차를 가립니다. Sim2Real Gap의 실체부터 Ditto, HumanLM, OdysSim 등 더 사람다운 시뮬레이터를 만들려는 최근 연구, 그리고 벤치마크를 읽고 만들 때 챙겨야 할 점까지 살펴봅니다.


Meta Muse의 등장은 개인화 AI 경쟁의 기준이 모델 성능에서 메모리, 워크스페이스, 실행 환경으로 옮겨가고 있음을 보여줍니다. ChatGPT, Claude, OpenClaw, Muse의 차이를 살펴보고, 이러한 변화가 추천·커머스·온라인 광고 산업을 어떻게 바꿀지 짚어봅니다.


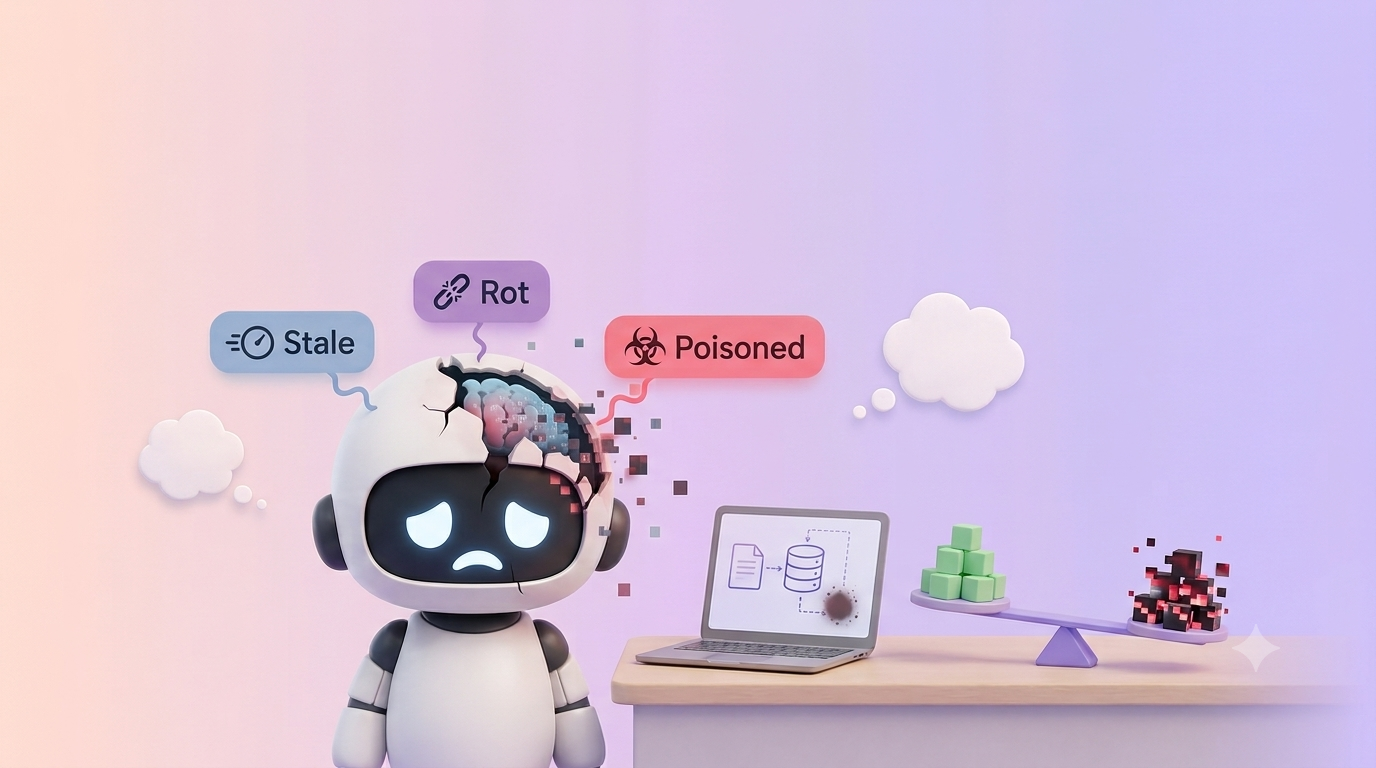
LLM Agent의 Memory는 오래될수록 더 믿을 만해질까요? 한때 맞았던 기억이 stale해지고, 반복적인 update 과정에서 왜곡되며, 외부 입력에 의해 poisoning될 수도 있습니다. Stale Memory부터 Memory Rot, Memory Poisoning까지, 장기 Memory가 망가지는 과정과 앞으로 필요한 lifecycle management를 살펴봅니다.


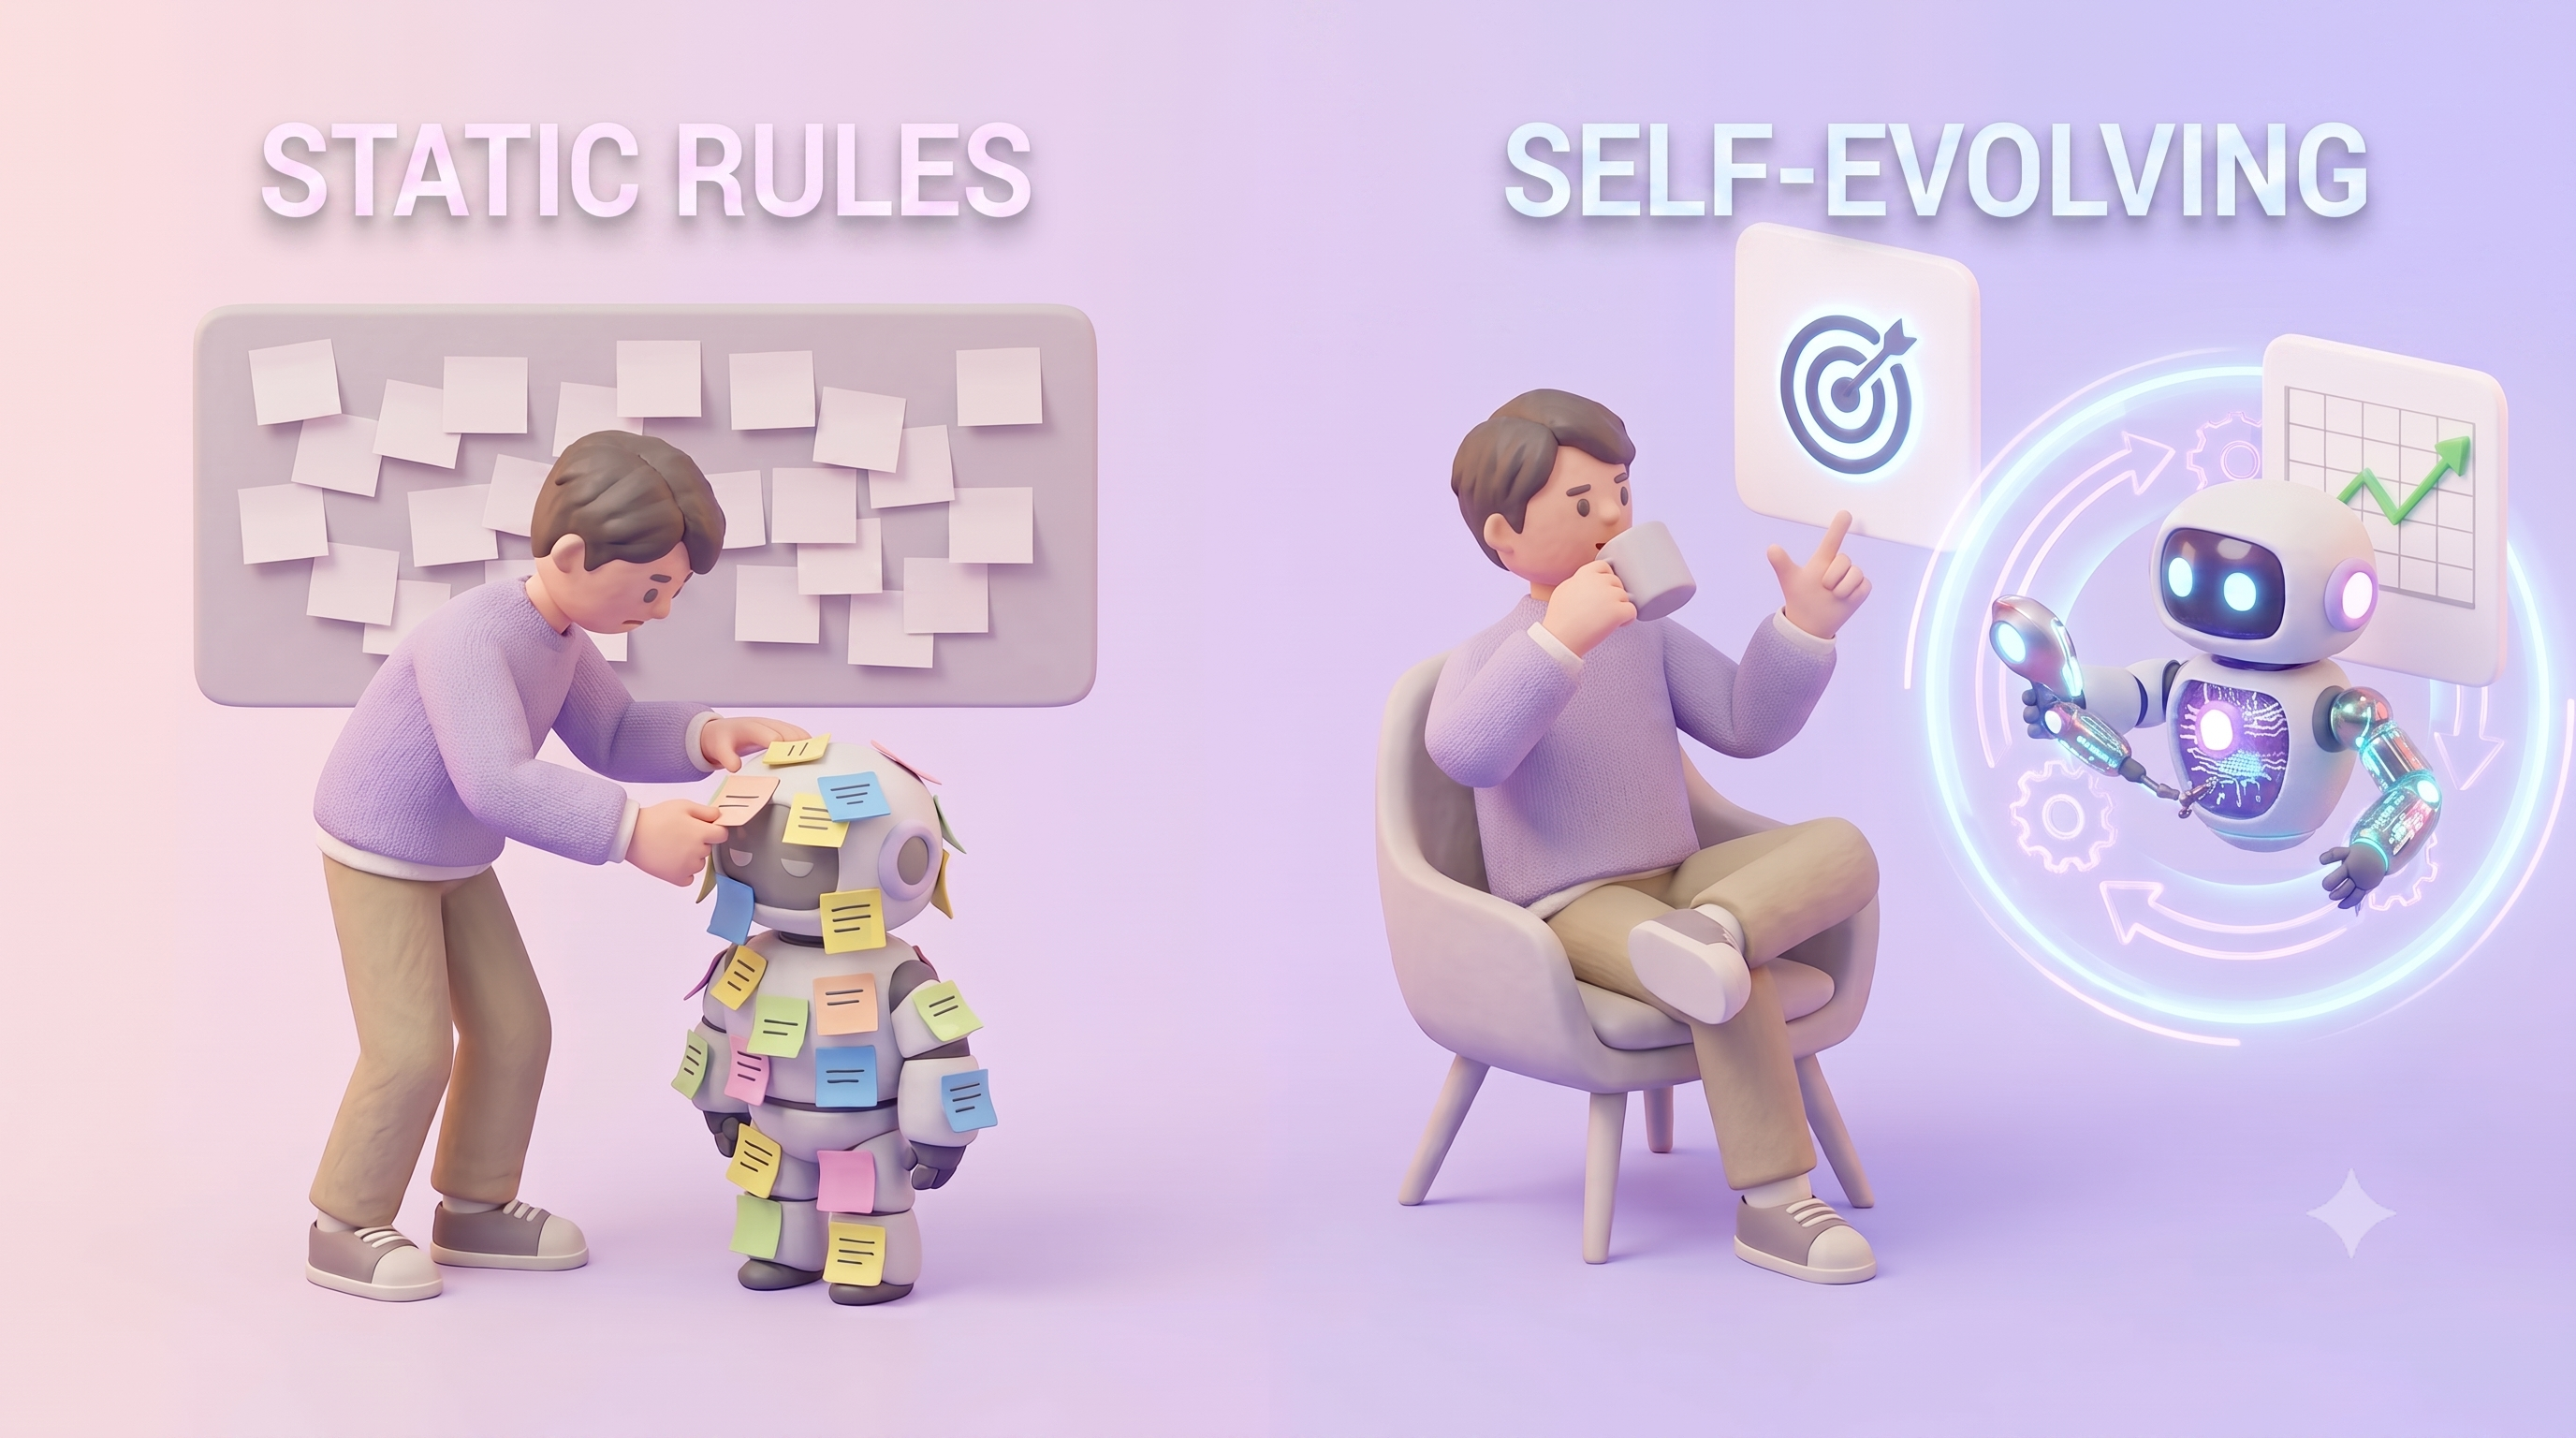
프롬프트, 컨텍스트, harness, loop engineering까지 병목은 계속 옮겨갔지만, 그것을 만들고 고치는 일은 늘 사람 몫이었습니다. 도구는 늘어나는데 관리하는 사람은 그대로이니, 한 번 만든 harness는 손대지 않으면 낡기만 합니다. Self-evolving agent는 이 고치는 일 자체를 에이전트에게 맡깁니다. 실행 기록을 읽고 자기 harness를 고쳐 나가는 방식으로, 모델은 그대로 두고도 성능은 오르고 토큰 비용은 줄었습니다. 어디까지 맡길 수 있는지, 맡기려면 무엇이 필요한지, 맡긴 뒤 사람에게 무엇이 남는지 살펴봅니다.

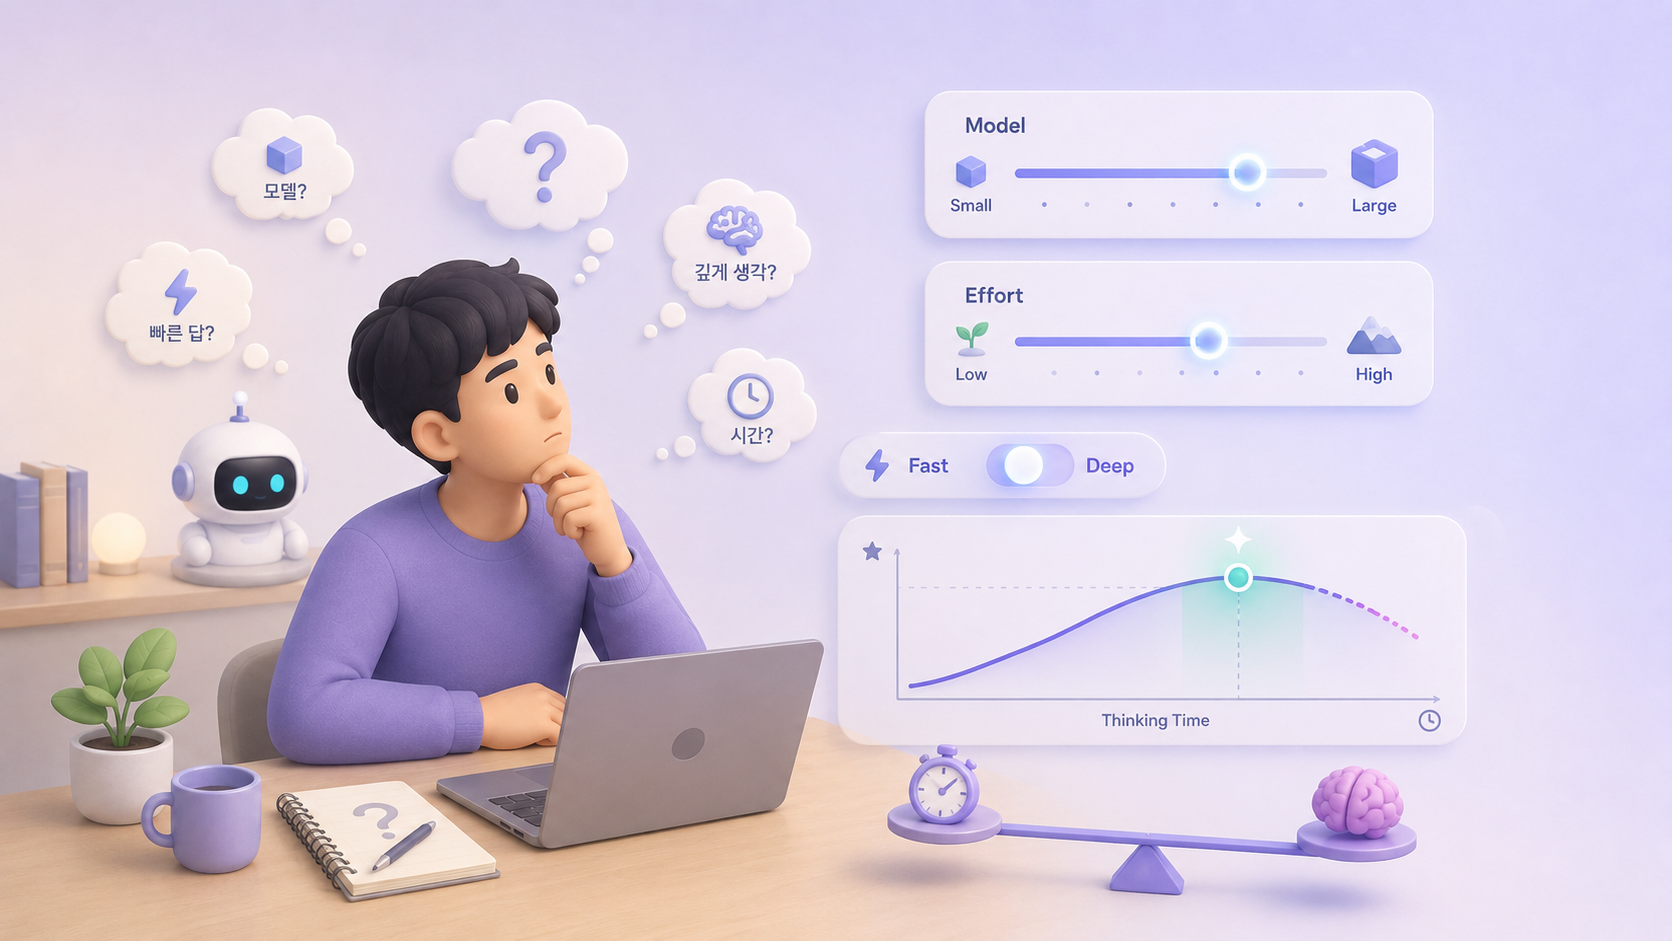
Thinking mode와 reasoning effort를 높이면 AI는 항상 더 정확해질까요? 최근 연구들은 추가 reasoning이 초반에는 도움이 되지만, 어느 순간부터 정답을 다시 의심하거나 같은 검증을 반복하는 overthinking으로 이어질 수 있음을 보여줍니다. 이 글에서는 더 많이 생각할 때 무엇이 달라지는지, 그리고 문제에 따라 reasoning을 어떻게 조절해야 하는지 살펴봅니다.

사람 개입 없이 이뤄진 AI 에이전트 결제가 누적 1억 6,900만 건을 넘었지만, 소비자 넷 중 셋은 여전히 AI에게 결제를 맡기기 불편하다고 답합니다. 이 어긋남을 읽으려면 구분이 하나 필요합니다. 내 카드를 쓰는 대리 결제와, 자기 지갑을 쓰는 x402 기반 자체 결제입니다. 두 유형이 각각 어떻게 작동하는지, 그 숫자가 실제로 얼마나 큰지, 그리고 위임 증명과 책임 규정이라는 남은 과제까지 차례로 짚어봅니다.


컨텍스트 윈도우를 키우는 대신, 필요한 정보를 검색하고 접고 복원하는 최신 에이전트 설계 패턴. Claude Code, Codex, Cursor가 긴 작업을 어떻게 이어가는지 핵심 인사이트만 정리합니다.


'지난 분기 매출 얼마나 늘었죠?' 문서는 다 찾아주는데도 AI가 답하지 못하는 건, 무엇을 매출로 볼지 그 기준이 어느 문서에도 없어서입니다. 기업 AI가 막히는 진짜 이유는 모델이 부족해서가 아니라, 판단에 필요한 맥락이 어디에도 구조화돼 있지 않다는 데 있습니다. 흩어진 기준·예외·승인·선례를 하나의 지도로 엮는 컨텍스트 그래프, 그리고 그 핵심인 판단 기록(decision trace)을 짚어봅니다.


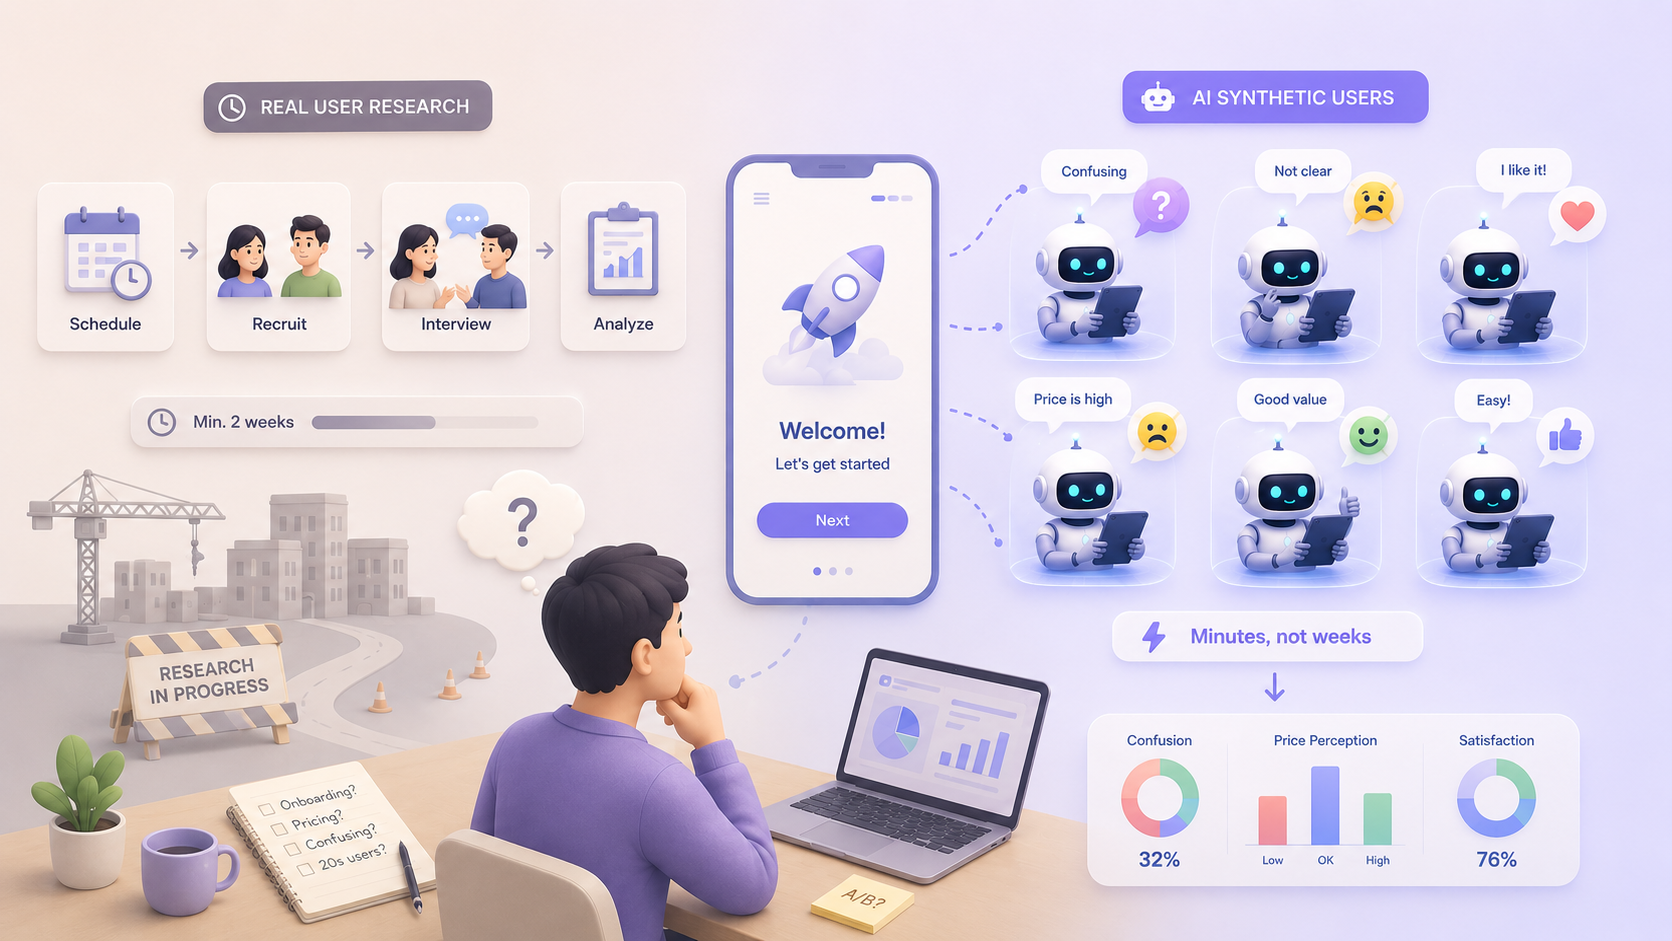
사용자 테스트는 느리고 비싸지만, AI 가상 사용자는 언제든 빠르게 피드백을 줍니다. Generative Agents에서 Synthetic Users로 이어지는 흐름을 따라, AI가 UX 평가에서 무엇을 도울 수 있는지, 실제 사용자와 어디서 달라지는지, 그리고 어디까지 맡겨도 되는지 짚어봅니다.


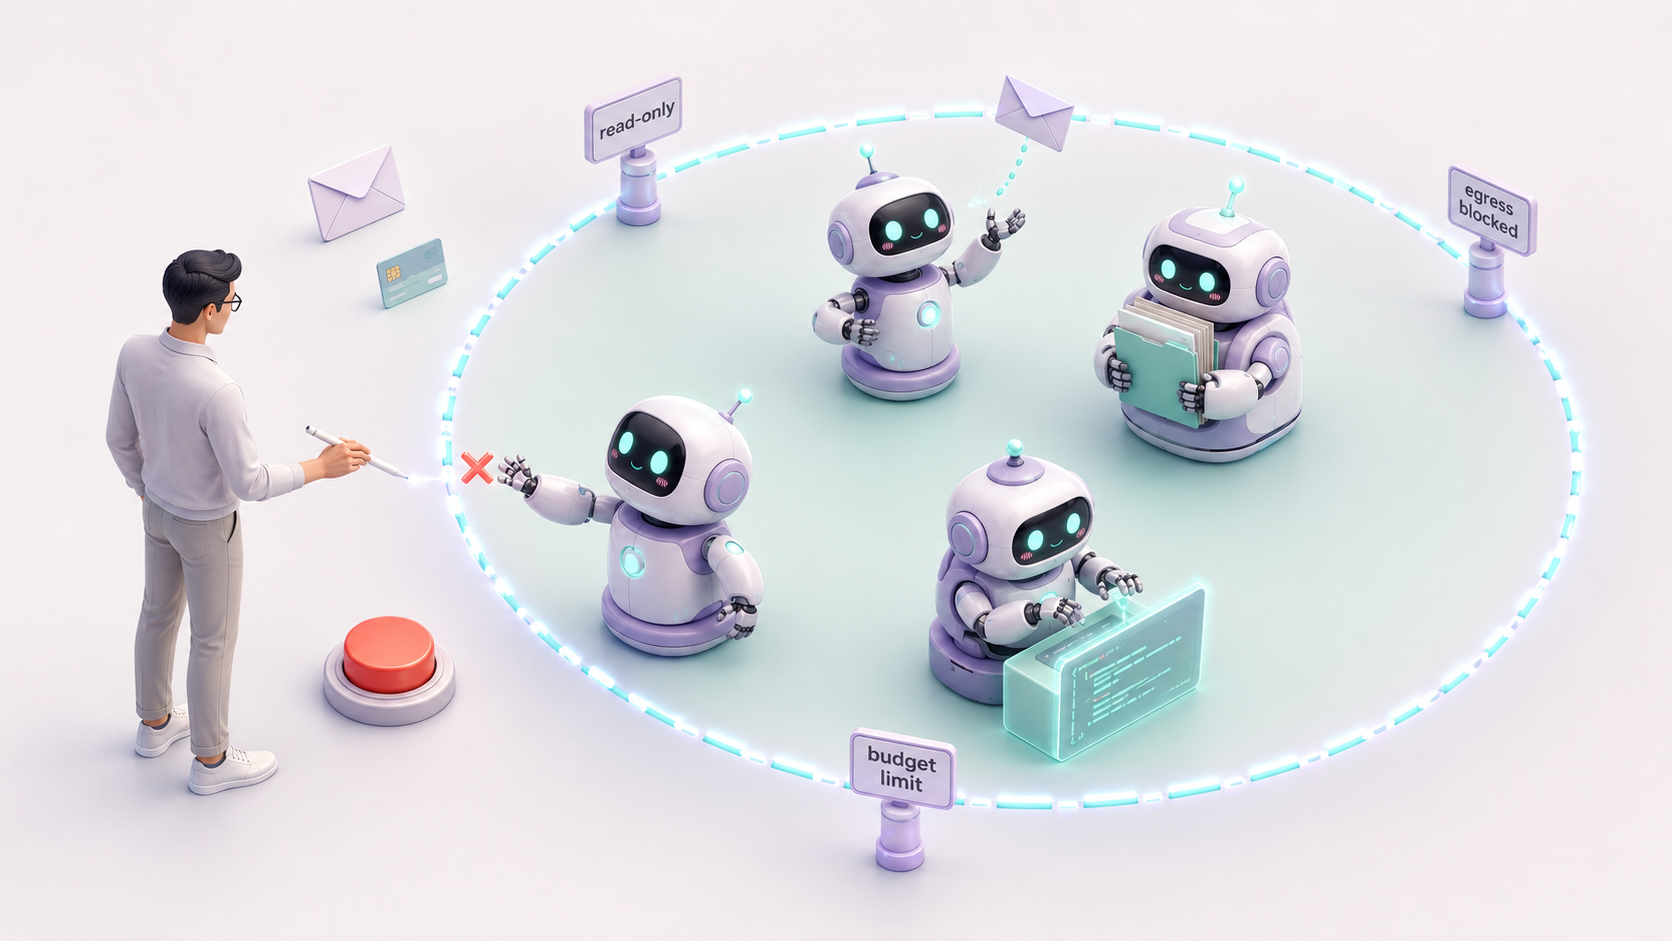
챗봇이 틀리면 다시 물으면 그만이지만, AI 에이전트가 틀리면 메일이 나가고 데이터가 지워지고 결제가 승인됩니다. 그래서 진짜 질문은 '얼마나 똑똑한가'가 아니라 '어디까지 맡겨도 되는가'입니다. 사고를 막는 예방과 완화 두 갈래, 그리고 무엇을 어디까지 맡길지 정하는 기준을 짚어봅니다.


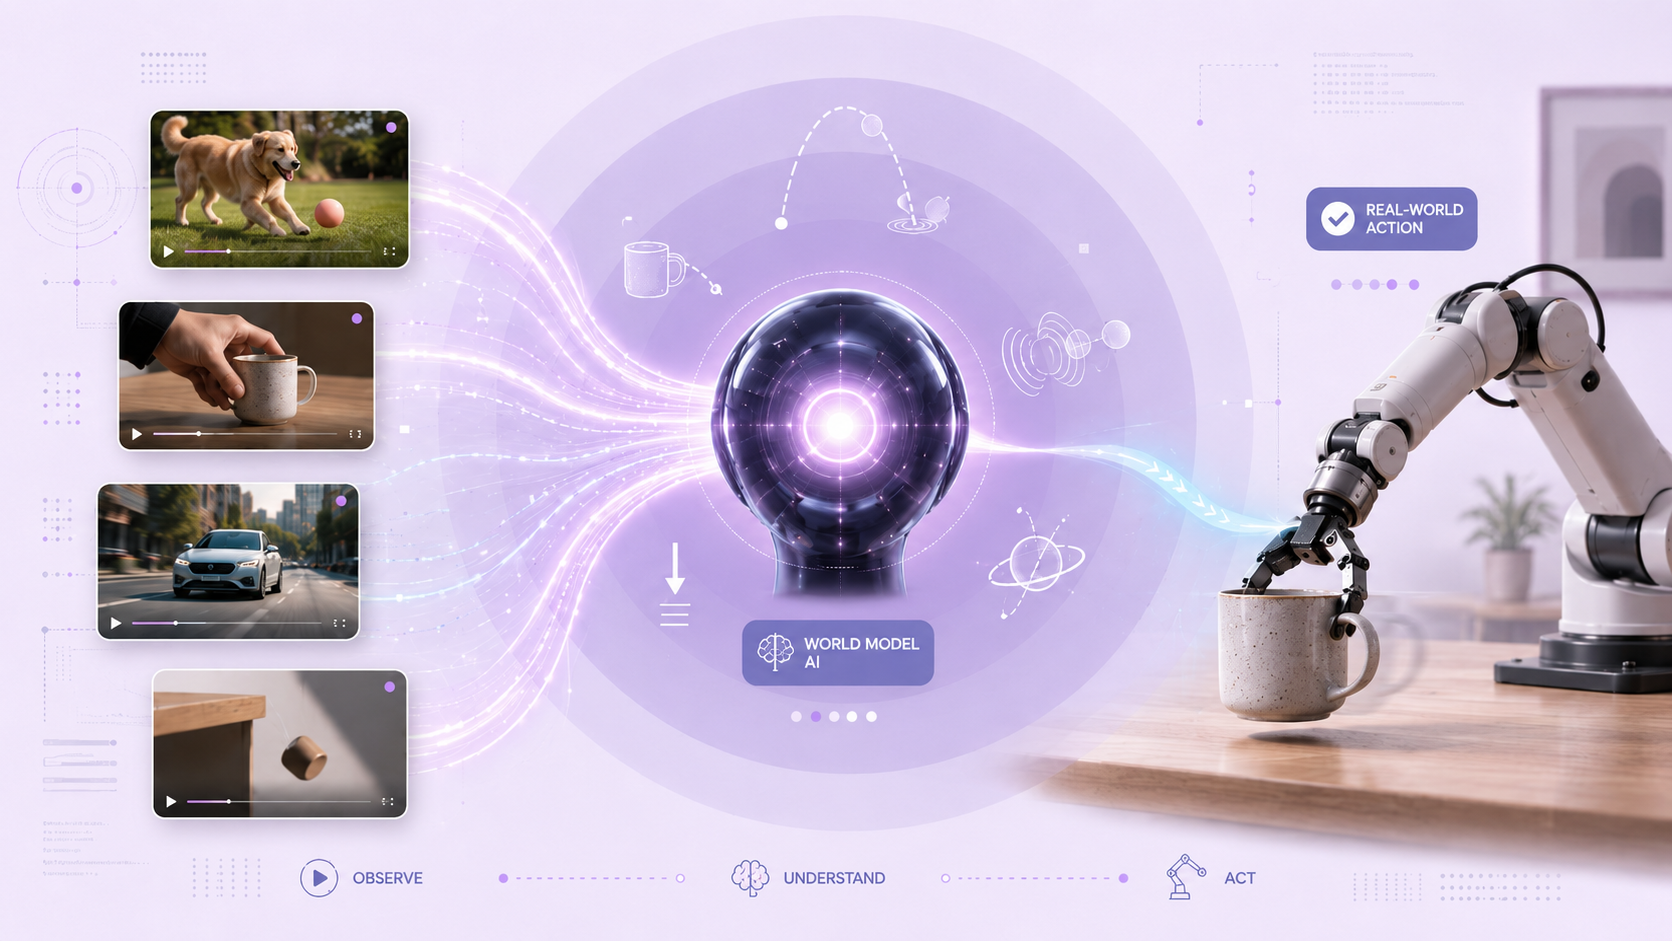
ChatGPT 이후 AI의 다음 방향으로 '물리 세계를 이해하는 AI'가 주목받고 있습니다. Meta의 V-JEPA 2는 픽셀을 복원하는 대신 잠재 공간에서 의미를 예측하는 방식으로, 100만 시간의 인터넷 비디오로 세상의 구조를 학습한 뒤 단 62시간의 로봇 데이터만으로 처음 보는 환경에서 로봇 팔을 제어하는 데 성공했습니다. I-JEPA부터 V-JEPA, V-JEPA2까지 흐름을 함께 살펴봅니다.

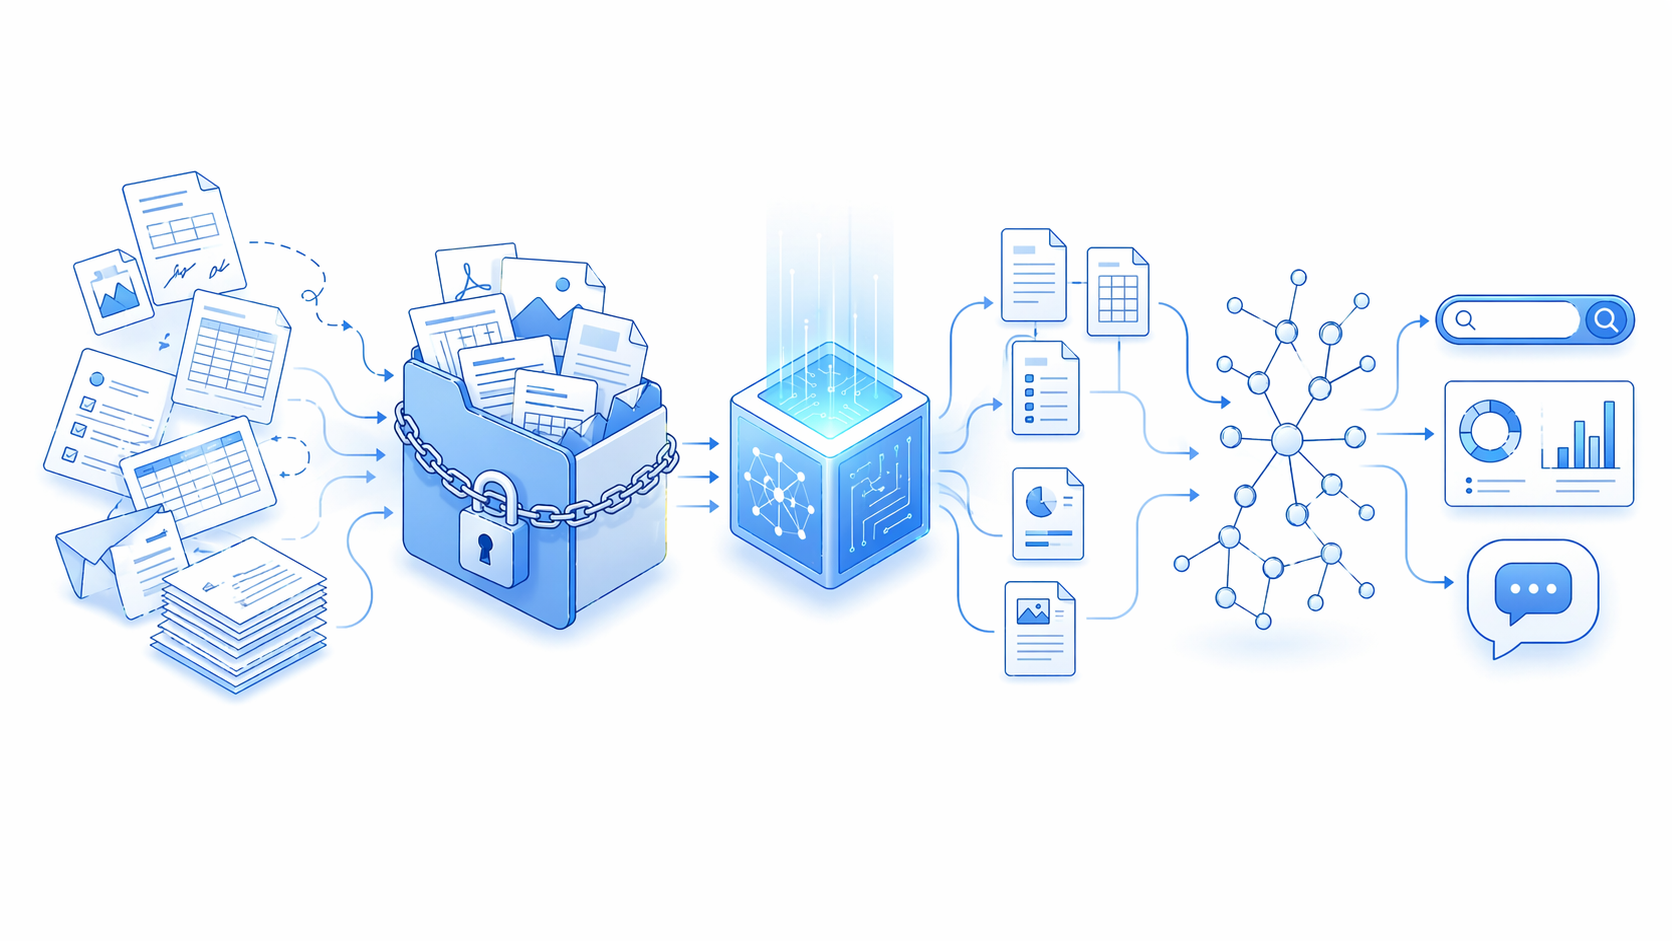
비정형 데이터 80% 시대, 기업 문서 AI는 페이지 검색을 넘어 '정확한 읽기'로 진화 중입니다. 관련 페이지를 찾아오는 데까지는 성공했지만, 정작 그 안에서 답을 읽어내는 일은 또 다른 문제입니다. 작은 글씨, 복잡한 표, 흩어진 시각 요소까지 놓치지 않으려면 모델은 어디를 어떻게 읽어야할까요?

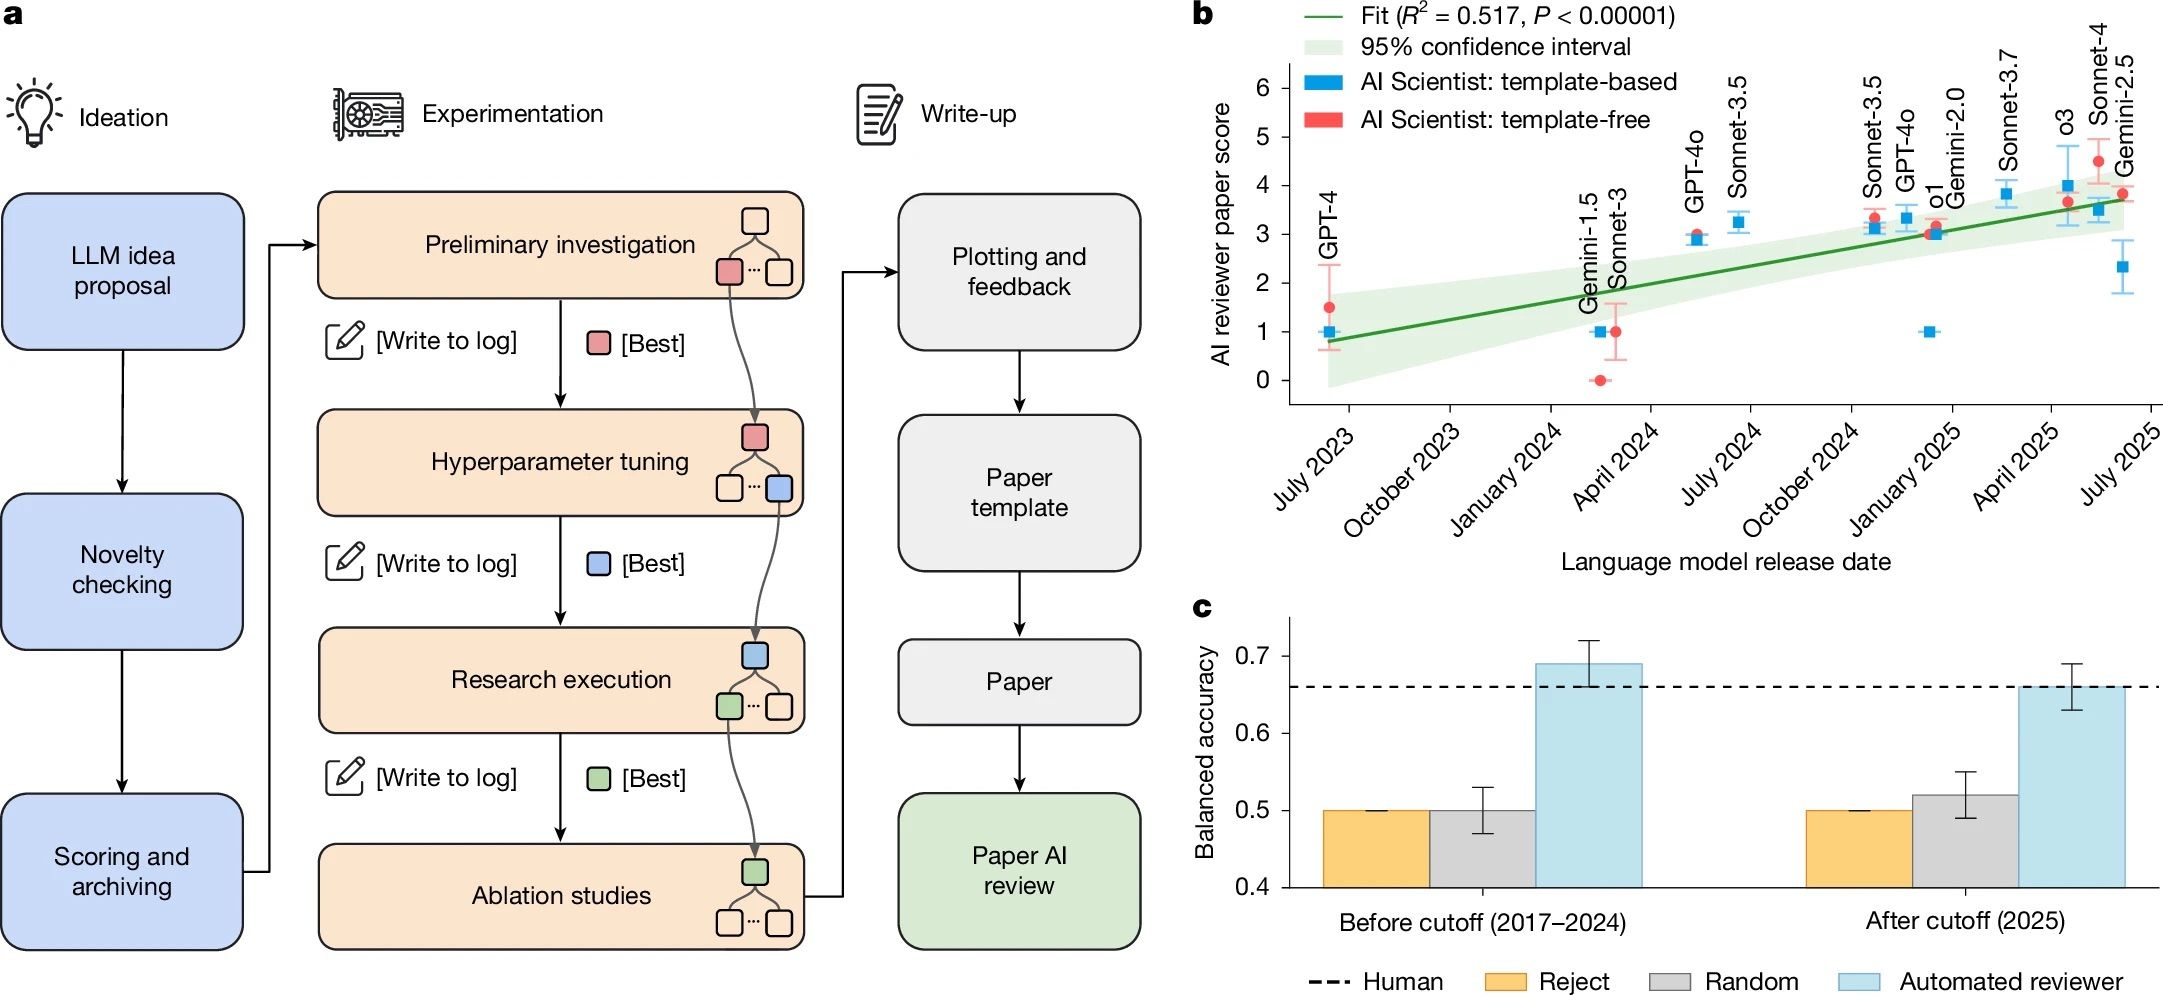
Karpathy의 autoresearch는 실험 루프를, Sakana AI의 AI Scientist는 아이디어부터 논문까지를 AI 에이전트에게 통째로 넘긴다. 메트릭 최적화의 한계는 분명하지만, 연구자의 역할이 실행에서 방향 설계로 이동하고 있다는 신호는 뚜렷하다.


AI가 웹에서 직접 행동하는 시대, 핵심은 모델의 지능이 아니라 그 지식을 행동으로 바꾸는 파이프라인이다. OpenClaw의 부상과 WebFactory의 intelligence compression을 통해 웹 에이전트 경쟁의 새로운 축을 짚는다.


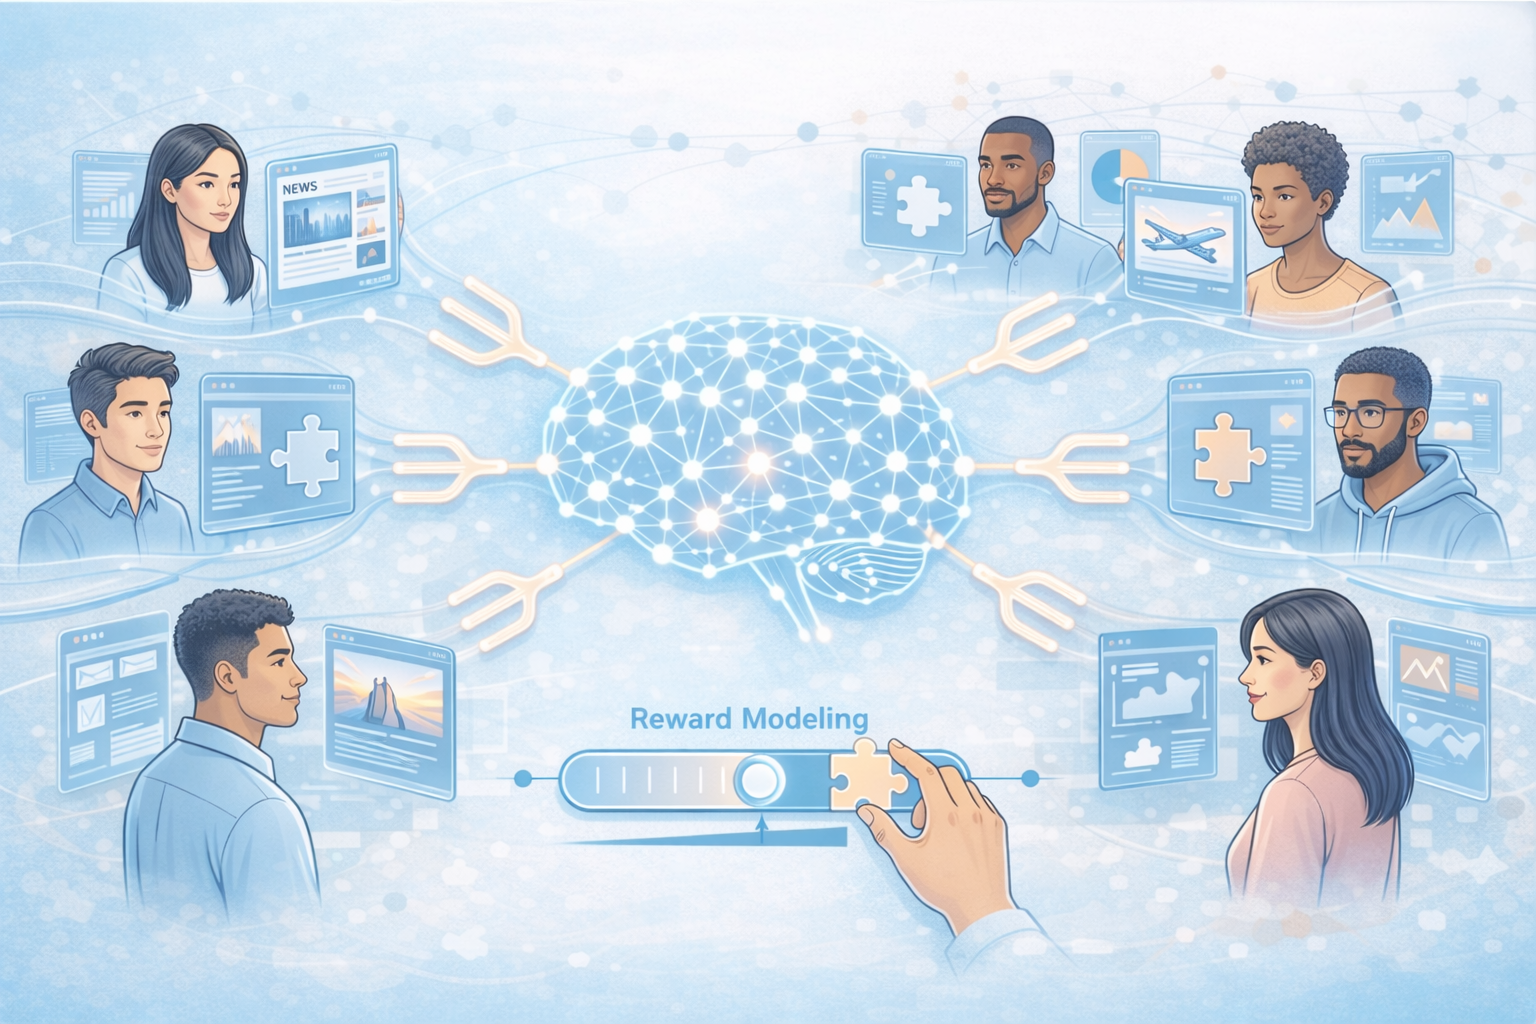
초개인화시대, 사용자는 이제 추천 리스트보다 ‘나에게 맞는 진행 방식’을 기대한다. 전통적 후보 노출 최적화에서 에이전트형 장기 상호작용 정렬로 넘어가며, 사용자 맞춤형 선호 기준을 학습 가능한 신호로 만드는 개인화 보상모델링과 P-Check의 인사이트.


PDF를 ‘검색 가능한 지식’으로 바꾸려면 텍스트 추출만으로는 부족합니다. DeepSeek OCR 2의 DeepEncoder V2와 구조화 출력을 중심으로, 기업 문서 지식화 파이프라인과 솔루션 선택 기준(로컬 vs API)을 한 번에 정리합니다.


사용자 행동의 변화와 AI 기술의 발전은 '에이전틱 커머스(Agentic Commerce)'라는 새로운 흐름을 만들어냈습니다. Adobe Business에 따르면, 2025년 10월 생성형 AI 소스에서 리테일 웹사이트로 유입된 트래픽은 전년 대비 1,200%나 급증했습니다. 더 주목할 점은 AI를 통해 유입된 방문자들의 구매 전환율이 일반 트래픽 대비 16% 더 높았다는 것입니다.


그렇다면 딥리서치 시스템이란 정확히 무엇일까요? 단순히 "검색해서 알려줘" 수준을 넘어, 복잡하고 답이 정해져 있지 않은 문제를 해결하기 위해 AI가 스스로 연구 계획을 세우고 실행하는 시스템을 말합니다. 최근 공개된 연구 "Fathom-DeepResearch"는 놀랍게도 단 4B(40억) 파라미터 크기의 작은 오픈 소스 모델(SLM)로도 최상위권의 딥리서치 성능을 낼 수 있음을 증명했습니다. 오늘은 이 논문을 바탕으로, 어떻게 작은 모델이 거대 모델들을 제치고 강력한 리서치 에이전트가 될 수 있었는지, 그 구체적인 레시피를 하나씩 뜯어보겠습니다.