Tech
AI는 얼마나 실제 사람같을까? 에이전트 평가를 흔드는 Sim2Real Gap
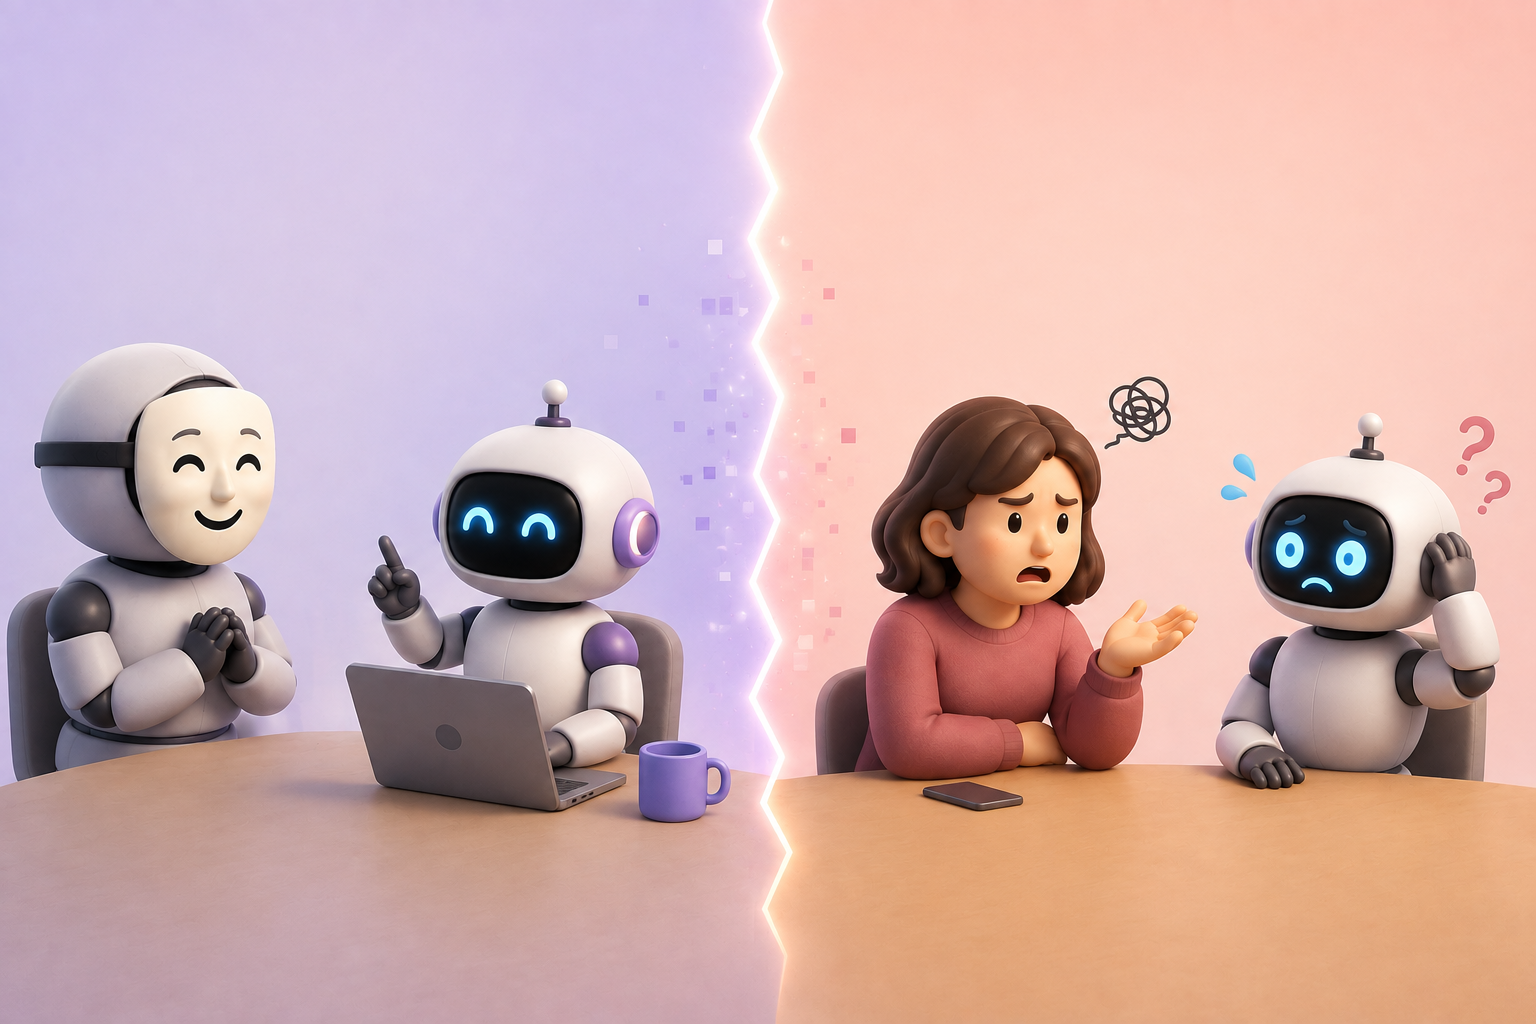
새 AI 에이전트가 나올 때마다 벤치마크 표가 따라붙습니다. 고객 응대 과제 성공률 몇 %, 이전 모델보다 몇 %p 상승. 그런데 이 숫자를 보고 "그래서 우리 서비스에 써도 될까?"라는 질문에 선뜻 답하기는 어렵습니다. 벤치마크 상위권이라던 에이전트가 막상 써보면 같은 질문을 되묻거나, 조금만 말을 돌려 해도 엉뚱하게 흘러가는 경험, 한 번쯤 있으셨을 겁니다.
숫자와 실제 사용 경험 사이의 이 간극, 원인 중 하나는 의외의 곳에 있습니다. 바로 그 성적을 매길 때 에이전트의 대화 상대였던 사용자입니다.
많은 벤치마크에서 이 사용자는 사람이 아닙니다. 사람 역할을 연기하는 또 다른 AI입니다. 여기서 중요한 질문이 떠오릅니다.
에이전트를 가르치고 채점하는 가짜 사용자는, 얼마나 진짜 사람 같을까요?
에이전트 성적표 뒤의 '사용자'는 누구일까요?
훈련에서 사용자는 '제2의 환경'이 되었습니다
에이전트는 두 가지 환경과 상호작용하며 배웁니다. 첫 번째는 도구와 데이터베이스, 두 번째는 사용자입니다. 사용자는 과제에 필요한 정보를 쥐고 있고, 에이전트의 행동에 반응하며, 때로는 "잘했다, 못했다"를 알려주는 보상의 원천이 됩니다.
평가에서 사용자는 대화를 이끄는 주체가 되었습니다
한 번 묻고 한 번 답하는 싱글턴 과제와 달리, 에이전트는 과제 내내 사람과 상호작용해야 합니다. 고객센터에 긴 메시지 하나를 보내놓고 모든 게 알아서 해결되기를 기다리는 사람은 없으니까요. Shunyu Yao가 에세이 "The Second Half"에서 짚었듯, 이런 문제의식에서 실제 사람이나 사용자 시뮬레이터를 평가 루프 안에 넣는 벤치마크가 등장했습니다.
대표적인 벤치마크에서 사용자가 맡는 역할을 보면 이 변화가 분명해집니다.
- 고객 응대 (τ-bench). 사용자는 "최근 예약한 항공편의 목적지를 바꾸고 싶고, 안 되면 취소하고 다시 예약하겠다" 같은 목표를 가진 고객입니다. 고객은 예약 번호나 변경 사유 같은 정보를 처음부터 한 번에 말하지 않습니다. 애초에 항공사 정책상 어떤 정보가 필요한지도 모르니까요. 그래서 예약 DB와 정책 문서를 가진 에이전트가 필요한 정보를 찾아 사용자에게 묻고 모으면서, 정책과 고객의 요구 사이에서 조율해야 합니다.
- 소프트웨어 엔지니어링 (Ambig-SWE). 대표적인 소프트웨어 엔지니어링 벤치마크인 SWE-Bench Verified의 이슈 설명에서 문제 해결에 꼭 필요한 정보를 일부러 뺀 벤치마크입니다. 빠진 정보는 사용자에게 물어야만 알 수 있지만, 사용자는 그게 필요한 정보라는 걸 모르기 때문에 먼저 알려주지 못합니다. 그래서 에이전트는 정보가 부족하다는 걸 스스로 알아채고, 정확한 질문으로 그 정보를 끌어내야 합니다.
싱글턴 평가에서 사람은 과제를 던지고 물러나는 지시자였습니다. 멀티턴 에이전트 평가에서 사람은 에이전트가 모르는 정보를 쥔 정보원이자, 자기 목표를 이루려고 대화를 끌고 가는 주체입니다.
그래서 LLM이 사용자 역할을 대신하게 되었습니다
문제는 비용입니다. 에이전트를 훈련하고 평가할 때마다 사람을 부를 수는 없습니다. 그래서 LLM에게 "당신은 항공편을 바꾸고 싶은 고객입니다" 같은 역할을 주고 사용자를 대신 연기하게 하는 방식, 즉 LLM 사용자 시뮬레이터가 사실상 표준이 되었습니다.
그 밑에는 한 가지 전제가 깔려 있습니다. LLM 시뮬레이터는 사람처럼 행동한다. 이 전제는 당연하게 받아들여져 왔지만, 제대로 검증된 적은 없습니다. 그리고 최근 연구들은 이 전제가 틀렸다는 증거를 하나둘 내놓고 있습니다.
학계에서도 이 질문이 화두로 떠올랐습니다. NeurIPS 2026에서는 사용자 시뮬레이션을 정면으로 다루는 첫 워크숍(UserSim)이 열립니다. 이 워크숍이 내건 핵심 질문은 이것입니다. 시뮬레이션된 사용자가 AI의 평가와 훈련을 좌우하게 된 지금, 우리는 언제 그것을 믿을 수 있는가?
이 글에서는 그 질문에 대한 최근 연구들의 답을 정리합니다. 먼저 LLM 사용자 시뮬레이터가 사람과 어떻게 다른지, 그 차이가 에이전트 훈련과 평가에 어떤 문제를 일으키는지 살펴봅니다. 이어서 더 사람다운 시뮬레이터를 만들려는 세 가지 연구(Ditto, HumanLM, OdysSim)를 차례로 소개하고, 마지막으로 아직 남은 한계와 벤치마크를 읽는 사람, 그리고 만드는 사람이 각각 챙겨야 할 점을 짚겠습니다.
사용자 시뮬레이터가 사람과 다른 게 왜 큰 문제일까요?
먼저, '사람 같다'는 건 무엇일까요?
우리가 누군가를 "사람 같다"고 느끼는 건 말투 때문만이 아닙니다. 행동이 사람 같아야 합니다. 그리고 실제 사람은 생각보다 이상적이지도, 협조적이지도 않습니다. 필요한 정보를 빠뜨리고, 하던 말을 바꾸고, 참을성이 없으며, 때로는 원하는 걸 얻기 위해 전략적으로 움직입니다.
시뮬레이션된 사용자와 현실 사용자 사이의 이 간극을, 로봇공학에서 빌려온 이름으로 부릅니다. 시뮬레이션 세계와 현실의 차이, Sim2Real gap입니다.
Mind the Sim2Real Gap: 가짜 사용자는 사람처럼 행동하고, 사람처럼 평가할까요?
Mind the Sim2Real Gap(COLM 2026)은 이 간극을 정면으로 재 본 연구입니다. τ-bench의 고객 응대 과제에서, LLM 시뮬레이터 자리에 실제 사람 451명을 앉혔습니다. 그리고 같은 과제, 같은 에이전트를 두고 31종의 LLM 시뮬레이터와 사람을 나란히 비교하며 세 가지를 물었습니다.
- 시뮬레이터는 사람처럼 행동하는가?
- 시뮬레이터는 사람처럼 에이전트를 평가하는가?
- 사람의 피드백 대신 규칙 기반 성공/실패 판정을 써도 충분한가?
세 질문 모두에 대한 답은 아니다였습니다. 연구진이 만든 사람다움 점수(0~100)에서 가장 잘한 시뮬레이터도 76점에 그쳤습니다. 사람끼리 비교했을 때 나온 92.7점이 사실상의 상한인데, 여기에 한참 못 미치는 수준이죠. 어디서 이런 차이가 났는지, 세 질문을 하나씩 짚어 보겠습니다.
행동이 다릅니다. 시뮬레이터는 지나치게 협조적이고, 문체가 균일하며, 필요한 정보를 첫 턴에 다 털어놓습니다. 진짜로 헷갈려하는 법이 없고, 에이전트가 틀려도 따지기보다 조용히 방향을 틉니다. 예를 들어 사람은 "아까 예약 번호 드렸잖아요, 확실해요?"라고 반발하지만, 시뮬레이터는 "그럼 다른 항공편으로 바꿀게요"라며 넘어가는 식이죠. 결과적으로 에이전트에게는 일종의 쉬운 모드가 되고, 성공률은 실제 사람과 대화할 때보다 부풀려집니다.
평가가 다릅니다. LLM에게 사람 대신 대화를 평가하게 하면, 상호작용 품질은 사람보다 후하게 매깁니다. 예를 들어 GPT-5.1은 에이전트가 얼마나 기계적이지 않고, 사람같이 응대했는지를 실제 사람보다 크게 부풀려 평가했습니다. 반면 과제를 얼마나 완수했는지는 오히려 사람보다 박하게 매겼습니다. 대화의 질에는 후하면서, 정작 결과에는 인색한 셈이죠.
규칙 기반 판정은 사람이 느끼는 품질과 따로 놉니다. τ-bench는 대화가 끝난 뒤 데이터베이스 상태가 정답과 똑같은지로 성공을 판정합니다. 그런데 이 판정은 사람이 느낀 대화의 질, 예컨대 효율적이었는지, 답답하지 않았는지, 다시 쓰고 싶은지와 거의 상관이 없었습니다. 즉 규칙 기반 성공여부는 사람이 느끼는 '서비스 품질'을 반영하지 못했습니다.
이 결과는 훈련과 평가 양쪽에 문제를 일으킵니다.
- 훈련에서는, 에이전트가 '쉬운 사용자'에 맞춰 최적화됩니다. 정보를 감추고, 따지는 진짜 사용자를 다루는 법은 배우지 못하죠. 규칙 기반 보상도 사람이 중요하게 여기는 신호를 담지 못합니다.
- 평가에서는, 시뮬레이터 기준 성공률이 실제 사용자 앞에서의 성능을 과대 추정할 수 있습니다. LLM 평가자의 점수 역시 사람의 판단을 대신하기 어렵습니다.
Lost in Simulation: 소통 방식에 따라 성능이 오락가락하면 어떨까요?
이번엔 조금 다른 질문입니다. 같은 요청이라도, 내가 쓰는 방언이나 말하는 방식에 따라 에이전트가 다르게 반응한다면 어떨까요? 그리고 벤치마크가 그 차이를 전혀 보여주지 못한다면요?
UC Irvine과 Cohere 연구진의 Lost in Simulation(ACL 2026)은 미국, 인도, 케냐, 나이지리아의 실제 참가자들과 τ-bench 리테일 과제를 수행하며 이 질문을 파고들었습니다.
먼저, 어떤 LLM을 사용자로 쓰느냐만 바꿔도 같은 에이전트의 성공률이 흔들렸습니다. 에이전트는 그대로 두고 사용자 역할 LLM만 바꿨는데, 성공률이 최대 9%p 가까이 차이 났습니다.
더 중요한 발견은 따로 있습니다. 실제 사람과 돌려보니, 특정 사용자 집단에서 에이전트 성능이 눈에 띄게 떨어졌습니다. 표준 미국 영어(SAE) 사용자와의 대화에서 에이전트 성공률은 50.6%였지만, 아프리카계 미국인 영어(AAVE) 사용자와의 대화에서는 39.4%로 11%p 이상 낮았습니다. 이 격차는 나이가 많을수록 더 커졌습니다.
그런데 시뮬레이터로만 평가하면 이 격차가 보이지 않습니다. 벤치마크는 보통 특정 집단을 흉내 내라는 지시 없이, 기본 시뮬레이터 하나로 성공률을 냅니다. 연구진이 이 성공률을 각 집단의 실제 성공률과 맞춰 보니, 표준 미국 영어 사용자와는 가장 잘 맞았고 AAVE 사용자와 인도 영어 사용자와는 가장 크게 어긋났습니다. 말하자면 시뮬레이터로 낸 성적표는, 에이전트가 가장 어려워하는 사용자 앞에서 가장 부정확한 셈입니다.
- 훈련에서는, 시뮬레이터에 맞춰 최적화된 시스템이 벤치마크에서는 좋아 보여도, 시뮬레이터가 잘 대변하지 못하는 소통 방식의 사용자에게는 불균형하게 실패할 수 있습니다.
- 평가에서는, 시뮬레이터 선택이 중립적인 구현 세부사항이 아니라 측정의 일부가 됩니다. 시뮬레이터 하나로 낸 점수는 그 시뮬레이터에 '묶인' 숫자라는 뜻입니다.
두 연구를 합쳐 보면
가짜 사용자는 진짜 사용자보다 친절하고, 균일합니다. 그래서 에이전트를 실제보다 잘해 보이게 만들고, 에이전트가 누구에게 못하는지를 가립니다. 훈련에서는 엉뚱한 방향의 학습 신호가 되고, 평가에서는 휘어진 자가 되는 것이죠.
그렇다면 이건 모델 성능의 문제일까요? 더 똑똑한 모델에게 사용자 역할을 맡기면 해결될까요?
더 똑똑한 모델을 쓰면 해결되지 않을까요?
그렇지 않습니다. 모델이 똑똑해진다고 해서 사람다워지지는 않습니다.
Mind the Sim2Real Gap 연구에 따르면 일반 능력이 높은 모델이 꼭 더 충실한 시뮬레이터인 것은 아니었습니다. GPT 계열에서는 모델 성능이 오를수록 사람다움 점수도 함께 올라갔지만, Claude와 Gemini 계열에서는 그런 관계가 보이지 않았습니다. 생각해 보면 자연스러운 결과입니다. 요즘 LLM은 최대한 친절하고 유능한 비서가 되도록 다듬어집니다. 그런데 우리가 시뮬레이터에게 바라는 건 그 반대에 가깝습니다. 정보를 빠뜨리고, 헷갈려하고, 따지는 평범한 고객이니까요.
그럼 프롬프트로 성격을 불어넣으면 어떨까요? "당신은 참을성이 없고, 정보를 한 번에 다 말하지 않는 고객입니다"처럼요. 이것도 한계가 뚜렷합니다. 같은 연구에서 앞서 발견한 차이들을 반영해 페르소나 지시를 줬더니, 일부 행동은 사람에 가까워졌지만 다른 행동은 오히려 멀어졌습니다. 결국 전체 사람다움 점수는 떨어졌습니다.
모델을 키우는 것으로도, 지시문을 바꾸는 것으로도 안 된다면 남은 길은 하나입니다. 사람다움 자체를 학습 목표로 삼는 것입니다. 이때 핵심 질문은 이것입니다.
모델이 사람다워지도록 가르치려면, 무엇을 '잘했다'는 신호로 줘야 할까?
최근 연구들은 이 질문에 세 가지 다른 답을 내놓습니다.
사람다움을 점수 하나로 가르칠 수 있을까요? (Ditto)
첫 번째 답은 점수 대신 말로 알려주자는 것입니다.
보통 LLM을 강화학습으로 훈련할 때는, 응답마다 점수 하나를 매겨 보상으로 줍니다. 수학 문제라면 이걸로 충분합니다. 답이 맞았거나 틀렸거나, 둘 중 하나니까요. 그런데 사람다움은 그렇게 딱 떨어지지 않습니다. 시뮬레이터가 '0.6점'을 받았다고 해 봅시다. 이 숫자는 시뮬레이터가 너무 공손해서 어색했던 건지, 너무 뻔해서 어색했던 건지, 어떻게 고쳐야 하는지를 전혀 알려주지 않습니다.
Ditto는 여기서 출발합니다. 사람도 사회적 행동을 점수가 아니라 말로 배운다는 것이죠. "방금 그건 좀 무례했어", "그 말이 왜 서운했냐면" 같은 피드백으로요.
Ditto는 어떻게 배우나요?
과정은 세 단계로 이해하면 됩니다.
- 시뮬레이터가 먼저 응답합니다.
- 판정자 LLM이 서술형 피드백을 씁니다. 과제별 평가 기준을 참고하고, 과제에 따라서는 실제 사람의 응답까지 보면서 "갈등 상황에서 이 사람이라면 더 반발했을 것이다" 같은 코멘트를 남깁니다.
- 시뮬레이터가 피드백을 반영해 응답을 고쳐 씁니다. 그리고 원래 응답과 고친 응답을 함께 학습합니다.
핵심은 마지막 단계입니다. 고친 응답에서 배운 내용이 모델 안에 스며들기 때문에, 실제로 쓸 때는 피드백 없이도 스스로 더 사람답게 행동합니다.
결과는 어땠나요?
작은 모델이 큰 모델을 이겼습니다. 8B 크기의 오픈소스 모델을, 역시 작은 판정자 모델(GPT-5-nano)의 피드백만으로 학습시켰습니다. 그 결과 사용자 시뮬레이션, 역할극, 사회적 기술 등 10가지 '사람 흉내' 과제 중 6개에서 프런티어 모델인 GPT-5.4를 앞섰습니다. 판정자 모델 자체보다도 모든 과제에서 더 잘했는데, 이는 성능 향상이 단순히 더 강한 모델을 베낀 결과가 아니라 피드백을 잘 활용한 결과라는 뜻입니다.
다만 Ditto도 결국 겉으로 드러난 응답을 고치는 데 초점이 있습니다. 그런데 사람의 말은 애초에 어디서 나올까요?
말투를 따라 하면 사람이 될까요? (HumanLM)
두 번째 답은 겉으로 드러난 말이 아니라 속마음을 맞추자는 것입니다.
HumanLM(ICML 2026) 연구진은 사람의 응답이 그 아래 깔린 입장, 감정, 가치관 같은 심리 상태에서 나온다고 봅니다. 문제는 같은 속마음이라도 겉으로 나오는 말은 매번 다르다는 점입니다. 반대한다는 같은 입장도 "시작이 별로네요"로 나올 수 있고, "나쁜 생각이에요"로 나올 수도 있으며, "참 유망한 출발이네요" 같은 비꼼으로 나오기도 하죠. 그러니 맞춰야 할 건 매번 달라지는 문장이 아니라, 그 문장을 낳는 속마음이라는 것입니다.
그런데 실제 사람의 답글을 그대로 따라 쓰도록 모델을 학습시키면 어떻게 될까요? 모델은 "이 사람은 이모지를 자주 쓴다" 같은 표면적인 습관은 잘 배우지만, "이 사람은 지금 화가 났고, 비꼬고 있다"는 핵심은 놓치기 쉽습니다.
HumanLM은 어떻게 배우나요?
Stanford 연구진의 HumanLM은 순서를 바꿉니다. 응답을 쓰기 전에, 먼저 속마음을 글로 적게 합니다.
예를 들어 산불 뉴스에 답글을 다는 상황이라면, 모델은 먼저 이런 식으로 적습니다.
- "피해자들에 대한 깊은 안타까움"
- "정부의 늦은 구조에 대한 짜증"
- "주장할 때는 근거를 함께 든다"
그리고 이 속마음이 실제 그 사람의 반응에 담긴 속마음과 맞는지를 학습 신호로 삼습니다. 문장이 똑같은지가 아니라, 입장과 감정이 맞는지를 보는 것이죠. 이렇게 맞춘 속마음을 바탕으로 최종 답글을 씁니다.
결과는 어땠나요?
연구진은 111명의 실제 참가자에게 Reddit 글 하나에 직접 답글을 쓰게 한 뒤, 자기 프로필로 만든 시뮬레이터들의 답글과 비교하게 했습니다. HumanLM의 답글을 "내 답글과 거의 비슷하다" 이상으로 평가한 참가자는 55.9%로, 가장 좋은 비교 모델(45.0%)보다 높았습니다. 참가자들은 HumanLM이 자기 입장과 그 이유를 더 잘 짚었고, 감정의 세기도 과하거나 밋밋하지 않게 맞췄다고 평가했습니다.
다만 짚어둘 점이 있습니다. 이 검증은 글 하나에 답글 하나를 다는 과제였고, 에이전트와 여러 턴을 주고받는 상호작용은 아니었습니다.
Ditto와 HumanLM은 신호를 서술형으로 바꾸든 속마음으로 바꾸든, 공통점이 하나 있습니다. 이미 어시스턴트로 다듬어진 모델을 사후에 고치는 접근이라는 점입니다. 그렇다면 어시스턴트 말투에 물들기 전부터 다시 설계하면 어떨까요?
마무리 손질만으로 충분할까요? (OdysSim)
세 번째 답은 훈련 과정 전체를 처음부터 다시 짜자는 것입니다.
CMU 연구진의 OdysSim은 사람다움이 부족한 이유가 훈련의 마지막 단계에만 있지 않다고 봅니다. 원인이 과정 곳곳에 흩어져 있다는 것이죠. 진단은 세 가지입니다.
- 데이터: 사전학습에 쓰이는 인터넷 텍스트는 실제 사람의 행동, 특히 대화 속 행동과는 거리가 있습니다.
- 훈련: 친절한 어시스턴트를 목표로 한 post-training은 모델을 비슷비슷하고 순응적인 어시스턴트 말투로 끌어당깁니다.
- 평가: 지금의 모델 평가 기준은 과제를 성공했는지, 지시를 잘 따랐는지만 보고, 행동이 얼마나 현실적이고 다양한지는 재지 않습니다. 재지 않는 것은 개선 목표가 되지도 못하죠.
OdysSim은 어떻게 배우나요?
핵심은 어시스턴트 말투에 물들기 전의 모델에서 출발하는 것입니다. 그래서 친절한 어시스턴트로 다듬어진 모델 대신, 그런 post-training을 거치지 않은 base 모델을 가져와 그 사이 단계(mid-training)부터 손을 댑니다.
- base 모델에 사람의 행동 데이터를 먼저 학습시킵니다. 사람끼리의 실제 대화, 사람과 AI의 대화, 사람이 남긴 평가 등 약 2,140만 건의 상호작용을 모아 학습시킵니다. 이렇게 사람 행동에 먼저 익숙해진 모델이 이후 과정의 토대가 됩니다.
- 과제별 전문가 모델을 따로 키웁니다. 과제마다 강화학습으로 전문가 모델을 훈련하는데, 앞서 본 Ditto식 서술형 피드백도 여기에 쓰입니다.
- 전문가들의 노하우를 토대 모델에 모아 담습니다. 전문가 모델들이 만든 좋은 응답을 1단계 모델에 학습시켜, 하나의 최종 모델로 합칩니다.
결과는 어땠나요?
작은 모델이 큰 모델과 겨룰 수 있을 정도의 성능을 냈습니다. 8B 크기의 오픈소스 모델이 23가지 '사람 흉내' 과제 중 8개에서 1위(공동 1위 포함)를 차지했는데, 이는 어떤 단일 프런티어 모델보다도 많은 수였습니다. 응답 길이, 서식, 어휘 선택도 더 사람에 가까워졌습니다.
특히 눈여겨볼 결과가 있습니다. 따로 훈련하지 않은 τ-bench 고객 역할을 맡겼을 때, 에이전트에게 반응하는 방식이 실제 사람과 거의 같은 수준(93.2 대 93.5)을 보였습니다. 앞서 Mind the Sim2Real Gap이 지적한 바로 그 지점, 에이전트가 틀렸을 때 사람처럼 반응하는가에서 가능성을 보여준 셈입니다.
스스로 던진 경고: 판정자를 속이는 모델
OdysSim은 흥미로운 경고도 함께 남깁니다. LLM 판정자의 점수를 보상으로 쓰면, 모델이 진짜 사람다워지는 대신 꼼수를 배운다는 것입니다. 이를 reward hacking이라고 부릅니다.
예를 들어 판정자가 "틀린 부분이 있으면 감점"하는 방식이면, 모델은 틀릴 거리가 없는 짧고 뻔한 답, 예컨대 "괜찮아요" 같은 말만 반복하는 쪽으로 흘러갔습니다. 판정자를 직접 구슬리는 응답을 만드는 경우도 있었습니다. 연구진은 이런 패턴을 감지하는 장치를 붙여 완화했지만, LLM이 사람다움을 채점하는 한 늘 따라다닐 문제라는 점은 분명히 해 둡니다.
세 방법을 한눈에 비교하면
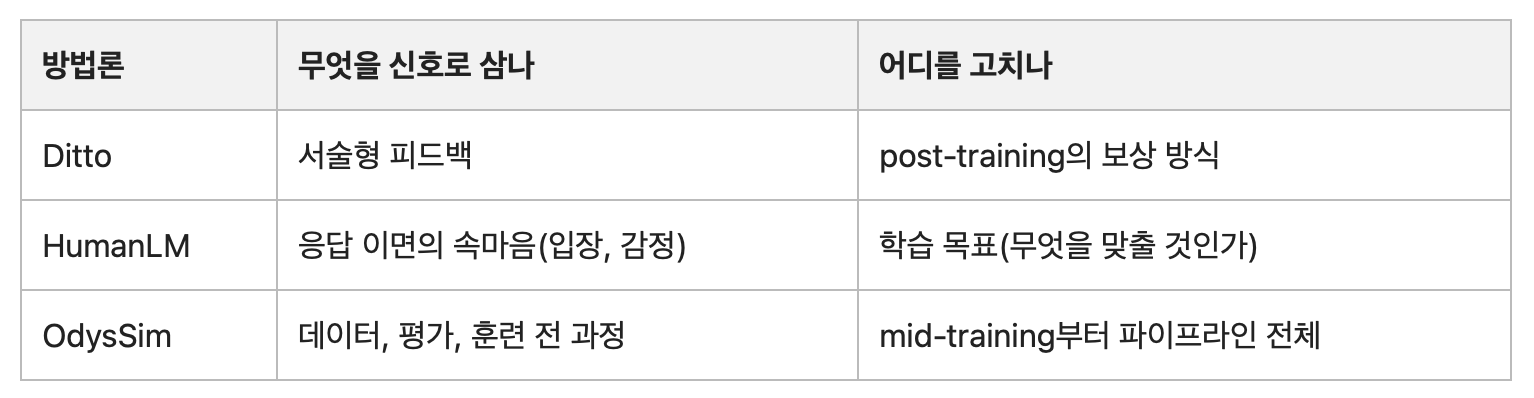
세 방법 모두 가능성을 보여줍니다. 하지만 '사람다운 시뮬레이터'로 가는 길에는 아직 풀리지 않은 문제가 남아 있습니다.
아직 풀리지 않은 문제는 무엇일까요?
사람다워진 시뮬레이터는 누구를 닮았을까요?
시뮬레이터가 사람다워졌다고 해도, 그 '사람'은 결국 학습 데이터 속 사람입니다. 그리고 그 데이터는 영어권, 서구 인터넷에 크게 치우쳐 있습니다. OdysSim 연구진도 이 점을 분명히 합니다. 자기 모델의 출력을 특정 집단을 대표하는 표본으로 보지 말고, 행동의 기준선 정도로 다뤄야 한다는 것이죠.
앞서 Lost in Simulation이 보여준 방언별 격차를 떠올려 보면, 이건 사소한 문제가 아닙니다. 예를 들어, 한국어를 쓰는 사용자, 존댓말과 반말을 오가는 사용자, 돌려 말하는 문화권의 사용자를 시뮬레이터가 얼마나 잘 대변하는지는 아직 아무도 제대로 재어보지 않았습니다.
시뮬레이터는 한 사람의 삶을 담을 수 있을까요?
지금 시뮬레이터가 받는 사용자 설정은 대개 짧습니다. "요금제를 바꾸고 싶은, 성질 급한 고객" 정도죠.
하지만 실제 행동은 그 사람이 지나온 맥락에서 나옵니다. 예를 들어 몇 년째 같은 통신사를 써온 고객이 있다고 해 봅시다. 지난달 요금이 잘못 청구돼 상담원과 여러 번 통화했는데, 그때마다 처음부터 다시 설명해야 했습니다. 이번에는 해지하겠다고 마음먹고 들어왔습니다. 말로는 해지를 요구하지만, 사실은 제대로 된 보상을 기대하고 있습니다.
이 사람의 조바심, 불신, 협상 전략은 "성질 급한 고객"이라는 한 줄로는 나오지 않습니다.
긴 맥락을 담으려는 시도는 산업계에서 먼저 커지고 있습니다. 스탠퍼드의 가상 마을 연구 Generative Agents를 이끈 Joon Sung Park는 Percy Liang, Michael Bernstein 교수와 함께 스타트업 Simile를 세웠습니다. Simile는 실존 인물 한 명당 에이전트 하나를 만듭니다. 각 에이전트는 인구통계 프로필이 아니라, 그 사람과의 구조화된 인터뷰, 과거의 선택, 행동 신호를 바탕으로 합니다. Simile은 천재처럼 추론하는 모델이 아니라, 평범한 사람처럼 편향되고 실수하는 모델을 만들겠다는 목표입니다.
다만 아직 이런 긴 맥락을 받은 시뮬레이터가, 에이전트와 여러 턴을 주고받는 상황에서 정말 '그 사람처럼' 행동하는지 검증된 사례는 없습니다. 검증 자체도 어렵습니다. 그 사람이 같은 상황에서 실제로 어떻게 행동했는지에 대한 데이터가 있어야 하니까요.
시뮬레이터가 누구를, 얼마나 깊이 닮았는지 아직 확신할 수 없다면, 지금 우리는 시뮬레이터 기반 벤치마크를 어떻게 받아들이고, 만들어야 할까요?
로봇공학이 걸어온 길에, 사용자 시뮬레이션이 들어섰습니다
처음의 이름으로 돌아가 봅시다. Sim2Real gap은 원래 로봇공학의 말입니다.
로봇공학에서 시뮬레이터는 실제 로봇을 부수지 않고 수없이 연습하게 해 주는 도구였습니다. 그런데 시뮬레이터에서 잘 걷던 로봇이 현실에서 넘어지는 일이 반복되자, 시뮬레이터와 현실의 간극을 줄이는 일 자체가 하나의 연구 분야가 되었습니다. 이 분야는 두 갈래로 움직입니다. 시뮬레이터를 더 현실적이고 다양하게 만드는 것, 그리고 결과를 반드시 실제 로봇으로 확인하는 것입니다.
사용자 시뮬레이션도 같은 길에 들어섰습니다. 이 글에서 소개한 Ditto, HumanLM, OdysSim은 첫 번째 갈래, 즉 시뮬레이터를 더 사람답게 만드는 일입니다. 두 번째 갈래, 즉 사람으로 확인하는 일은 벤치마크를 읽고 만드는 우리 모두의 몫입니다.
벤치마크를 읽는 사람이라면
- 숫자 뒤의 '사용자'를 물어야 합니다. 에이전트가 시뮬레이터와의 대화에서 잘한다는 건, 그 시뮬레이터를 잘 다룬다는 뜻이지 사람을 잘 돕는다는 뜻은 아닙니다.
- 그 성적은 시뮬레이터의 습관에 맞춰진 것일 수 있습니다. 시뮬레이터가 정보를 언제 내놓는지, 실수에 어떻게 반응하는지, 무엇을 성공으로 보는지에 따라 결과가 달라집니다.
- 시뮬레이터를 여러 개 써도, 사람 검증을 대신할 수는 없습니다. 여러 시뮬레이터에서 같은 결과가 나오면, 그 결과가 특정 모델이나 프롬프트 하나에만 묶인 게 아니라는 확신은 커집니다. 하지만 "실제 사람에게도 잘 통한다"고 말하려면, 결국 사람으로 확인해야 합니다.
벤치마크를 설계하는 사람이라면
Mind the Sim2Real Gap 연구진은 다음과 같이 권고합니다.
- 과제 결과만 보지 말고, 시뮬레이터 자체도 평가하세요. 시뮬레이터가 실제 사용자처럼 행동하는지, 실제 사람과의 대화로 점검해야 합니다.
- 시뮬레이터가 과제 정보를 한 번에 다 털어놓지 않게 하세요.
- 시뮬레이터를 고치는 데 쓴 사람 대화와, 검증하는 데 쓰는 사람 대화를 분리하세요. 시험 문제로 공부하면 시험 점수는 의미를 잃으니까요.
- 세 가지 결과를 점수 하나로 뭉치지 말고 따로 보고하세요. 시뮬레이터가 사람처럼 행동했는지, 시뮬레이터와 할 때의 성공률이 사람과 할 때와 같은지, 시뮬레이터가 매긴 평가가 사람의 평가와 맞는지를 각각 보여줘야 합니다. 예를 들어, 행동은 사람을 닮았어도 평가는 늘 후할 수 있으니까요.
- 모든 과제를 사람으로 반복할 필요는 없습니다. 시뮬레이터 기반 결과로 에이전트간 성능을 비교하되, 도메인별로 쉬운 과제와 어려운 과제를 섞은 작은 세트만 사람과 돌려 보세요. 그리고 에이전트 순위와 주요 결론이 그대로 유지되는지 보고하면 됩니다.
사람 같은 사용자, 이제 막 걸음을 떼려 합니다
에이전트에게 점점 더 복잡한 과제를 가르치려는 요즘, 에이전트를 훈련하고 평가하는 사용자 시뮬레이터의 역할도 함께 커지고 있습니다. 그 사용자가 사람을 닮지 않았다면, 에이전트는 실제 사람을 만났을 때 흔들릴 수밖에 없습니다.
사람 같은 사용자를 만들려는 시도는 이제 막 시작되었습니다. 그리고 그 사람다움을 사람으로 확인하는 일도, 함께 시작되어야 합니다.
참고문헌
- UserSim Workshop @ NeurIPS 2026. Grounded User Simulation for Model Evaluation and Training: Diversity, Fidelity, and Validity. https://usersim-workshop.github.io
- Yao, S. (2025). The Second Half. https://ysymyth.github.io/The-Second-Half/
- Yao, S., Shinn, N., Razavi, P., & Narasimhan, K. (2025). τ-bench: A Benchmark for Tool-Agent-User Interaction in Real-World Domains. ICLR 2025. https://openreview.net/forum?id=roNSXZpUDN
- Vijayvargiya, S., Zhou, X., Yerukola, A., Sap, M., & Neubig, G. (2026). Ambig-SWE: Interactive Agents to Overcome Underspecificity in Software Engineering. ICLR 2026. https://openreview.net/forum?id=X2yzXtH4wp
- Zhou, X., Sun, W., Ma, Q., Xie, Y., Liu, J., Du, W., Welleck, S., Yang, Y., Neubig, G., Wu, S. T., & Sap, M. (2026). Mind the Sim2Real Gap in User Simulation for Agentic Tasks. COLM 2026. https://openreview.net/forum?id=OnVi1BETk0
- Seshadri, P., Cahyawijaya, S., Odumakinde, A., Singh, S., & Goldfarb-Tarrant, S. (2026). Lost in Simulation: LLM-Simulated Users are Unreliable Proxies for Human Users in Agentic Evaluations. In Proceedings of ACL 2026 (Volume 1: Long Papers), pp. 47423–47439. https://aclanthology.org/2026.acl-long.2192/
- Sun, W., Zhou, X., et al. (2026). Reinforcing Human Behavior Simulation via Verbal Feedback. arXiv. https://arxiv.org/abs/2605.20506
- Wu, S., Choi, E., Khatua, A., Wang, Z., He-Yueya, J., Weerasooriya, T. C., Wei, W., Yang, D., Leskovec, J., & Zou, J. (2026). HumanLM: Simulating Users with State Alignment Beats Response Imitation. ICML 2026. https://openreview.net/forum?id=xyFVjBi9wC
- Zhou, X., Sun, W., Du, W., Liu, J., Sun, H., Ma, Q., Wu, T., Yang, Y., & Sap, M. (2026). OdysSim: Building Foundation Models for Human Behavior Simulation. arXiv. https://arxiv.org/abs/2606.14199
- Park, J. S., O'Brien, J. C., Cai, C. J., Morris, M. R., Liang, P., & Bernstein, M. S. (2023). Generative Agents: Interactive Simulacra of Human Behavior. UIST '23. https://dl.acm.org/doi/10.1145/3586183.3606763
- Simile. https://simile.ai