AI Insight
AI 에이전트는 스스로 진화할 수 있을까? 시키는 시대에서 맡기는 시대로 / 프롬프트 엔지니어링에서 self-evolving agent까지

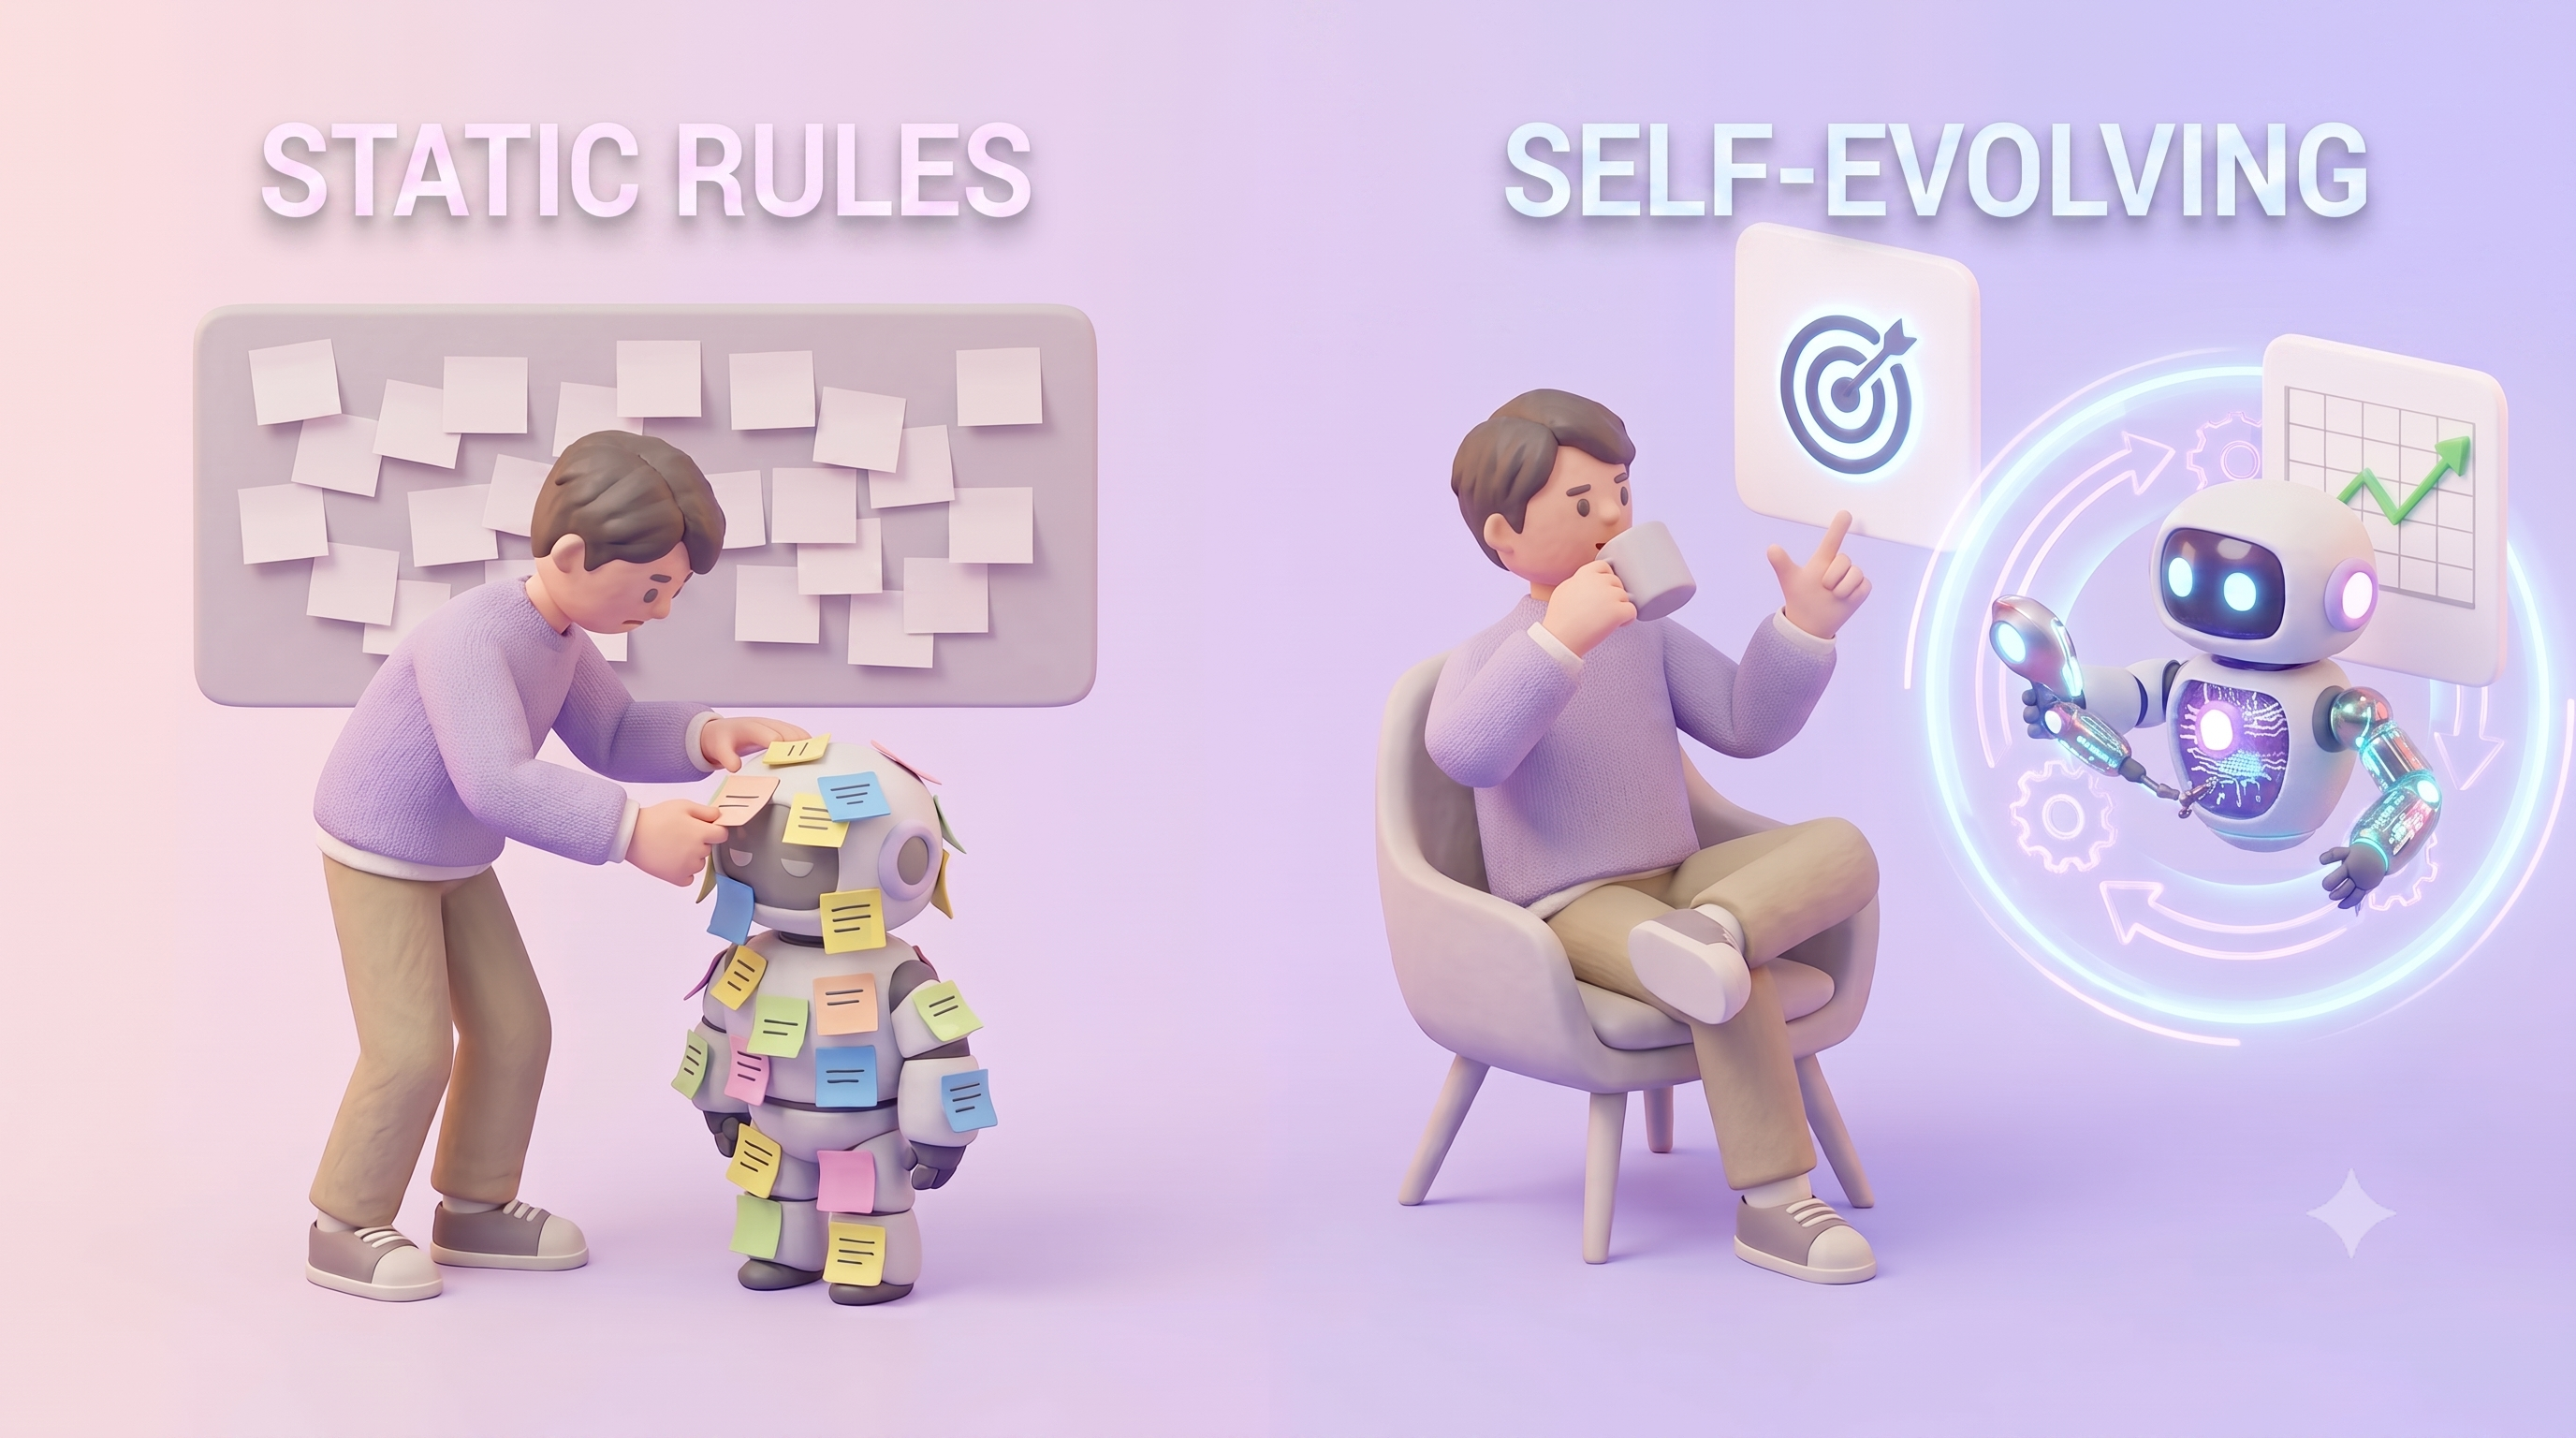
요즘 일을 어떻게 시작하시나요? 기획서를 쓰든, 아이디어를 정리하든, 코드를 짜든, 처음부터 끝까지 직접 하는 사람은 이제 드뭅니다. 대부분은 먼저 AI에게 물어보고 시작하고, 어떤 사람은 큰 목표만 던져 놓고 에이전트가 끝까지 하게 둡니다. 둘 다 같은 일을 하지만, 사람이 어디까지 개입하느냐가 다릅니다.
OpenAI(2026.02)에서 Codex로 다섯 달 만에 100만 줄짜리 제품을 만든 팀은 코드를 사람이 한 줄도 쓰지 않았습니다. 수작업으로 코드를 작성했을 때 걸렸을 시간의 약 1/10 정도의 시간으로 작성되었다고 말 하고 있습니다. 이 팀이 초기에 가장 많은 시간을 쓴 일은 따로 있었습니다.
매주 금요일, 주 업무시간의 20%를 통째로 에이전트가 남긴 잡동사니를 치우는 데 썼습니다. 코드는 에이전트가 쓰는데, 에이전트가 잘 쓰게 만드는 규칙과 문서는 사람이 고치고 있었던 겁니다. 같은 글에서 이 팀은 커다란 AGENTS.md 하나를 두는 방식이 실패한 이유도 적었습니다. 만드는 순간부터 Outdated 되기 시작하고, 사람은 손을 놓고, 파일은 낡은 규칙의 무덤이 된다는 것입니다.
사람이 매번 설계하고 고치는 쪽이 시키는 시대, 사람은 목표와 기준만 주고 개선은 AI가 하는 쪽이 맡기는 시대입니다. OpenAI는 이것을 네 단어로 요약합니다. "Humans steer. Agents execute."
그런데 프롬프트를 다듬던 시절부터 컨텍스트를 설계하고, harness를 짜고, 루프를 돌리는 지금까지, 병목이 옮겨갈 때마다 새 이름이 붙었지만 그것을 만들고 고치는 주체는 한 번도 바뀌지 않았습니다. 늘 사람이었고, 도구가 늘어나는 속도를 사람이 따라가지 못하니 늘 관리되지 못하고 현재 상태를 반영하지 못하는 old data가 되고있습니다. 지난달 모델이 업그레이드됐을 때, 프롬프트도 같이 좋아졌나요?
harness를 고치는 일 자체를 에이전트에게 맡기는 self-evolving agent 연구가 올해 쏟아졌고, 성능은 올랐고, 같은 일을 하는 데 드는 LLM 호출과 토큰, 즉 컴퓨팅 비용은 줄었습니다. self-evolving이 무엇이고 무엇을 맡길 수 있는지(연구 지형도) → 실제로 어떻게 작동하는지(Meta-Harness) → 제품은 어디까지 왔는지 → 맡기려면 무엇이 필요한지 → 맡긴 뒤 사람에게 무엇이 남는지 순서로 살펴봅니다.
프롬프트 엔지니어링에서 self-evolving agent까지, 병목은 어떻게 이동했을까?
프롬프트 엔지니어링부터 loop engineering까지의 네 단계는 사람이 넘기는 것이 하나씩 늘어난 순서로 읽을 수 있습니다. 프롬프트 문구를 직접 다듬던 단계가 병목이 아니게 되자 무엇을 모델에게 보여줄지(컨텍스트)가, 컨텍스트가 정리되자 모델을 둘러싼 시스템 전체(harness)가, 시스템이 갖춰지자 그것을 반복시키는 구조(loop)가 병목이 됐습니다. 하나가 풀리면 다음 것이 드러나는 식입니다.
여기서 harness는 모델을 둘러싼 모든 것을 뜻합니다.
이 단계들에서 눈여겨볼 패턴이 하나 있습니다. 사람의 개입이 줄 때마다 성능은 오르고 비용은 줄었습니다. 컨텍스트 칸의 예를 하나만 들면, Cursor의 dynamic context discovery는 도구 설명 전체를 컨텍스트에 밀어 넣는 대신 필요할 때 찾아보게 바꿨고, MCP 도구를 호출한 실행의 전체 토큰이 46.9% 줄었습니다. (jaehoon kim, yonsei DLI)
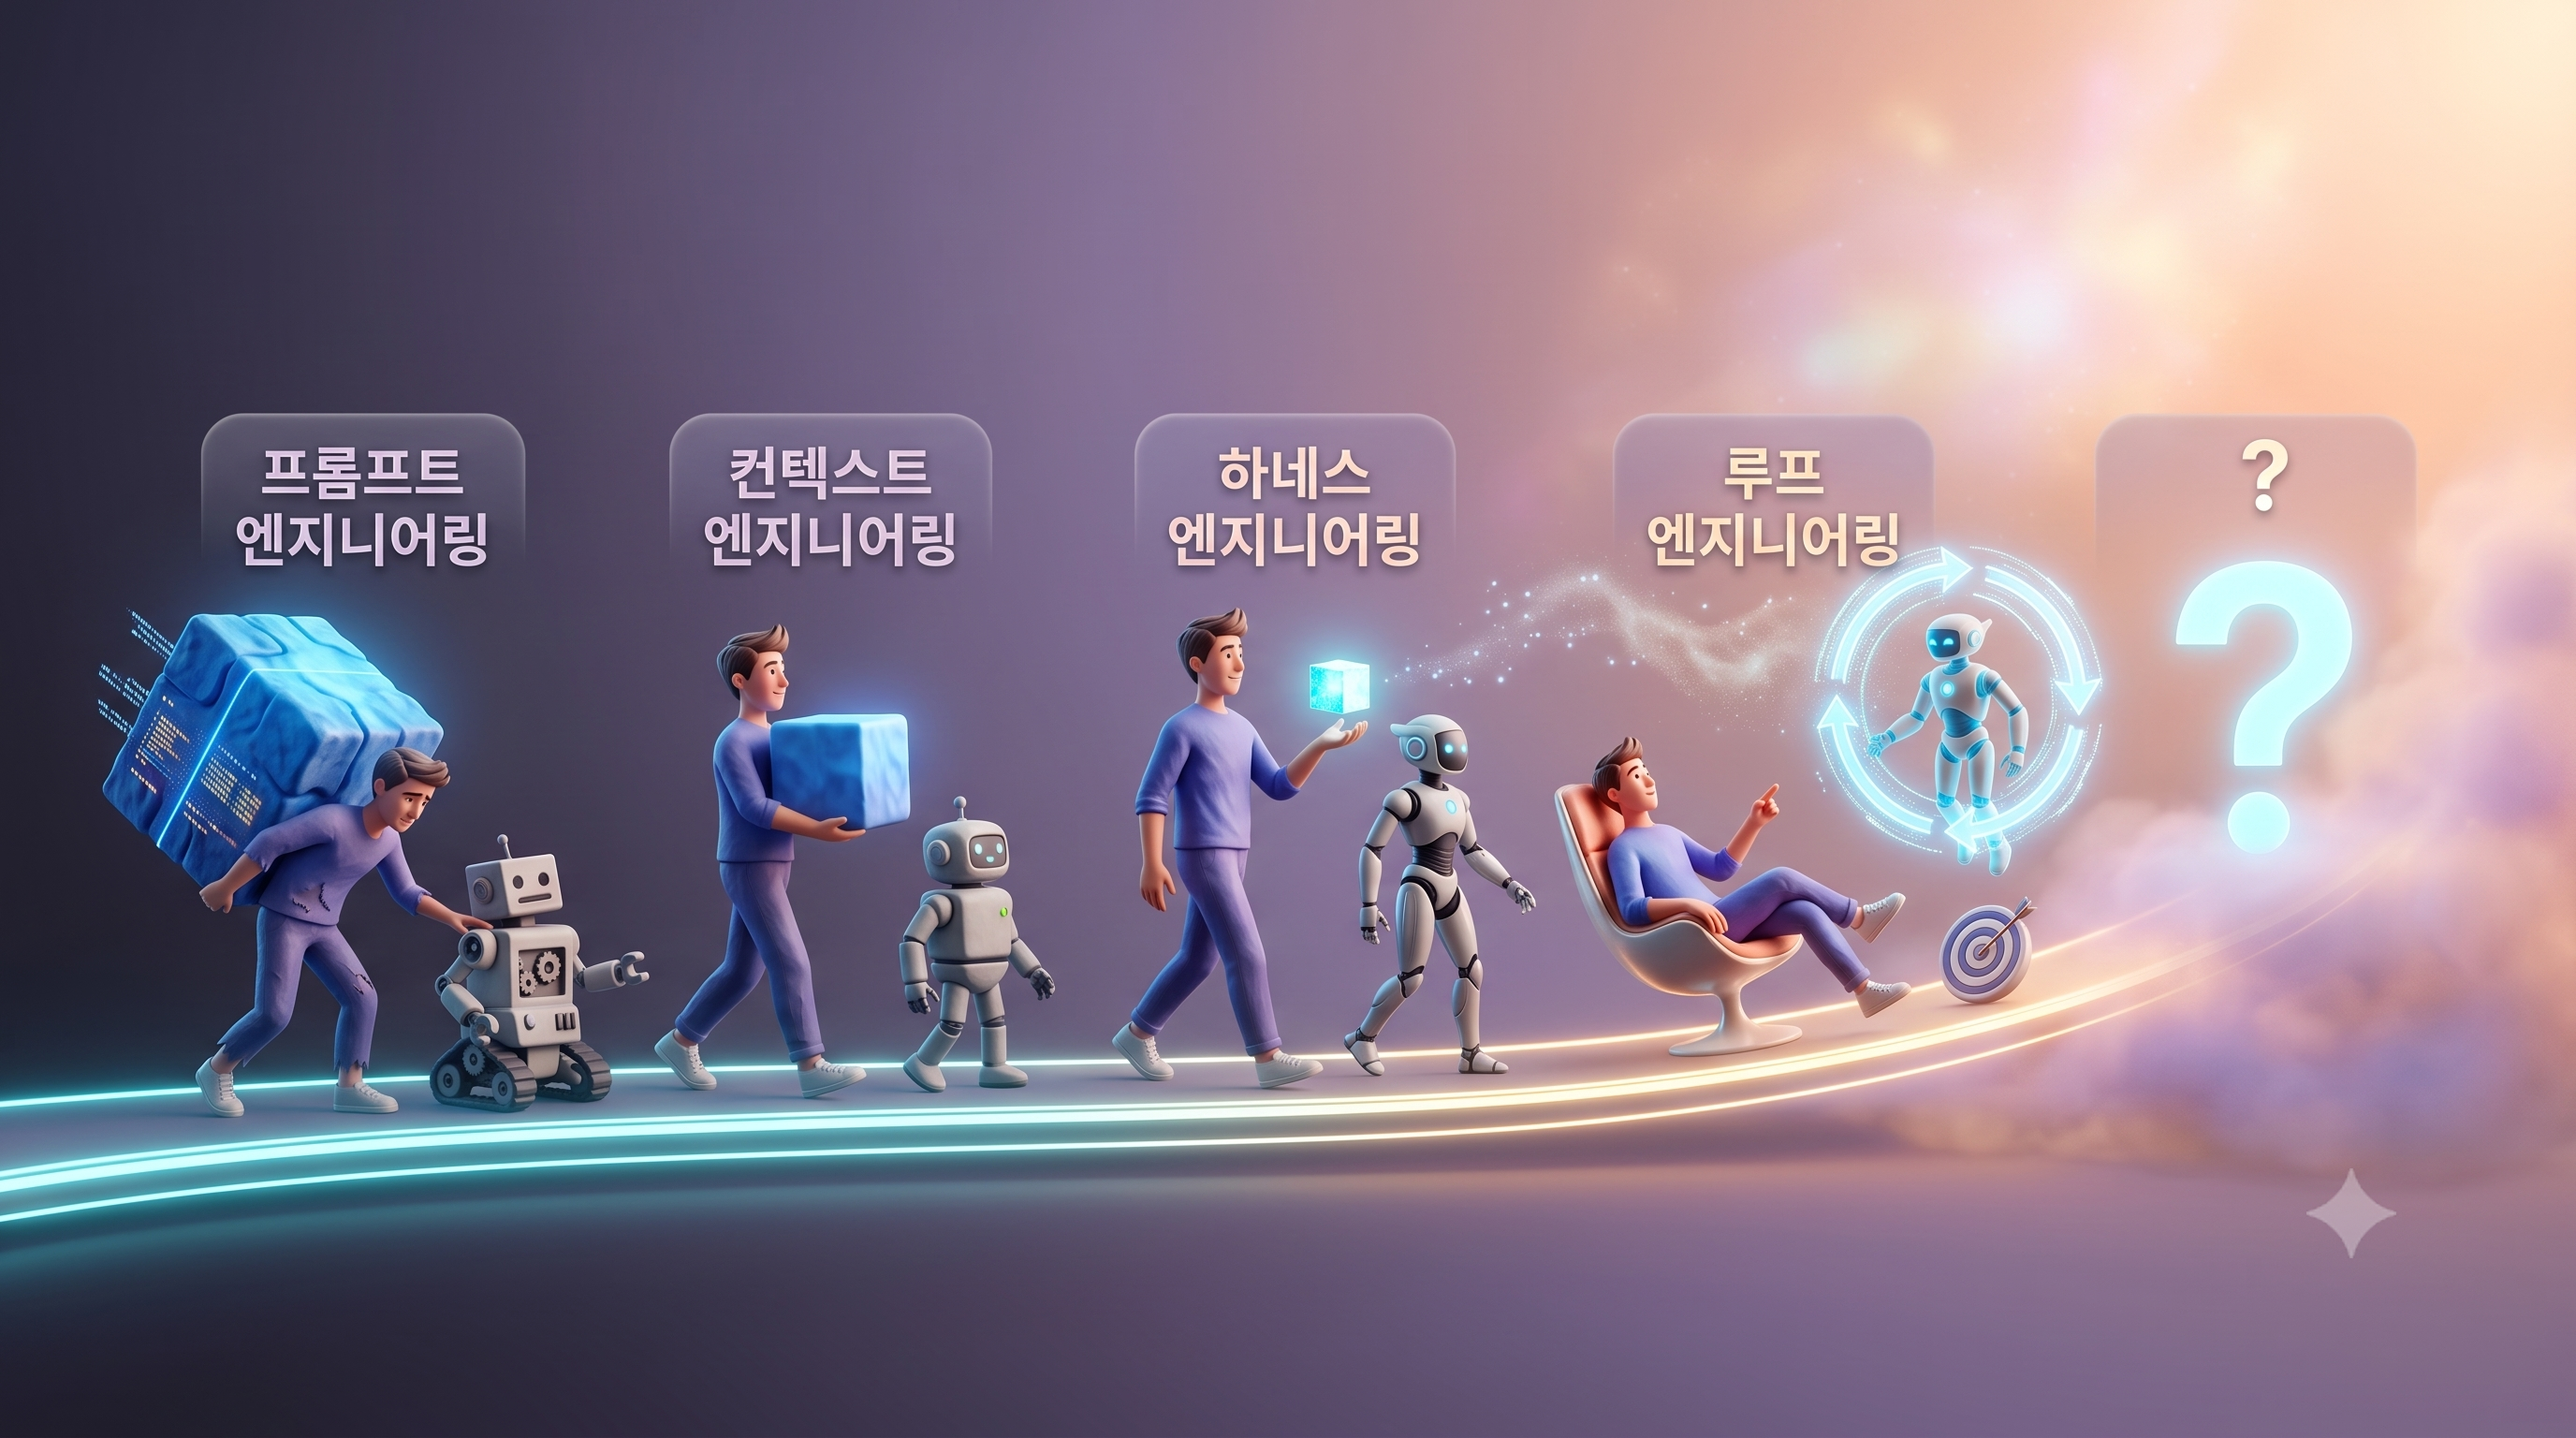
“단계가 넘어갈수록 사람의 개입은 줄고 성능은 올랐습니다. 그럼 다음 단계에서도 이 패턴이 유지될까요?”
Google의 Addy Osmani(2026.06)는 loop engineering을, 사람이 매번 에이전트에게 프롬프트를 주는 대신 그 일을 대신할 시스템을 설계하는 것으로 정의합니다. Anthropic Claude Code 팀(2026.06)은 루프를 네 종류로 나누는데, 종류마다 사람이 넘기는 것이 하나씩 늘어납니다.
- Turn-based loop: 검증을 넘긴다
- Goal-based loop(
/goal): 종료 조건을 넘긴다 - Time-based loop(
/loop,/schedule): 트리거를 넘긴다 - Proactive loop: 프롬프트 자체를 넘긴다
자동화 단계 프롬프트까지 넘겨도, 검증 skill과 종료 조건과 스케줄은 여전히 사람이 씁니다. 네 단계 전부 사람이 만들고 사람이 고치니, 루프의 부품들은 배포한 도구 수 곱하기 팀 수만큼 늘어나는데 관리하는 사람은 그대로입니다. 만든 날이 가장 좋은 상태고, 그 뒤로는 낡기 시작합니다.
Lilian Weng(2026.07)은 최적화 대상이 지시 프롬프트에서 구조화된 컨텍스트로, 워크플로로, harness로 옮겨 왔고, 그 다음은 harness를 고치는 코드 자체라고 정리합니다. 고치는 일까지 넘기는 것이 self-evolving입니다.
Self-evolving agent란 무엇이고, 무엇을 스스로 진화시킬까?
Self-evolving agent는 사람이 목표와 평가 기준을 주면, 에이전트가 자기 실행 기록(trajectory)을 읽고 자기 harness를 고치고, 고친 것이 더 나은지 평가해서 반영하는 루프입니다. 자동 프롬프트 최적화는 예전부터 있었지만 두 가지가 다릅니다.
- Optimize 대상: 프롬프트 문구 → harness 전체
- Optimizer가 보는 정보: 점수 → 실행 기록 원본
올해 나온 self-evolving 연구는 "무엇을 진화시키나"로 layer가 나뉩니다. 밖에 있는 텍스트를 고치는 얕은 layer에서 모델 안의 policy를 고치는 깊은 layer까지, layer마다 대표 연구 하나씩과 인사이트들을 정리했습니다.
GEPA(Agrawal et al., ICLR 2026 Oral)는 실행 기록에서 무엇이 잘못됐는지 자연어로 정리한 뒤 프롬프트를 고칩니다. 여섯 개 태스크에서 GRPO보다 평균 6pt 높으면서 rollout은 최대 35배 적게 썼습니다. 언어로 된 피드백이 스칼라 보상보다 훨씬 밀도 높은 학습 신호라는 뜻입니다.
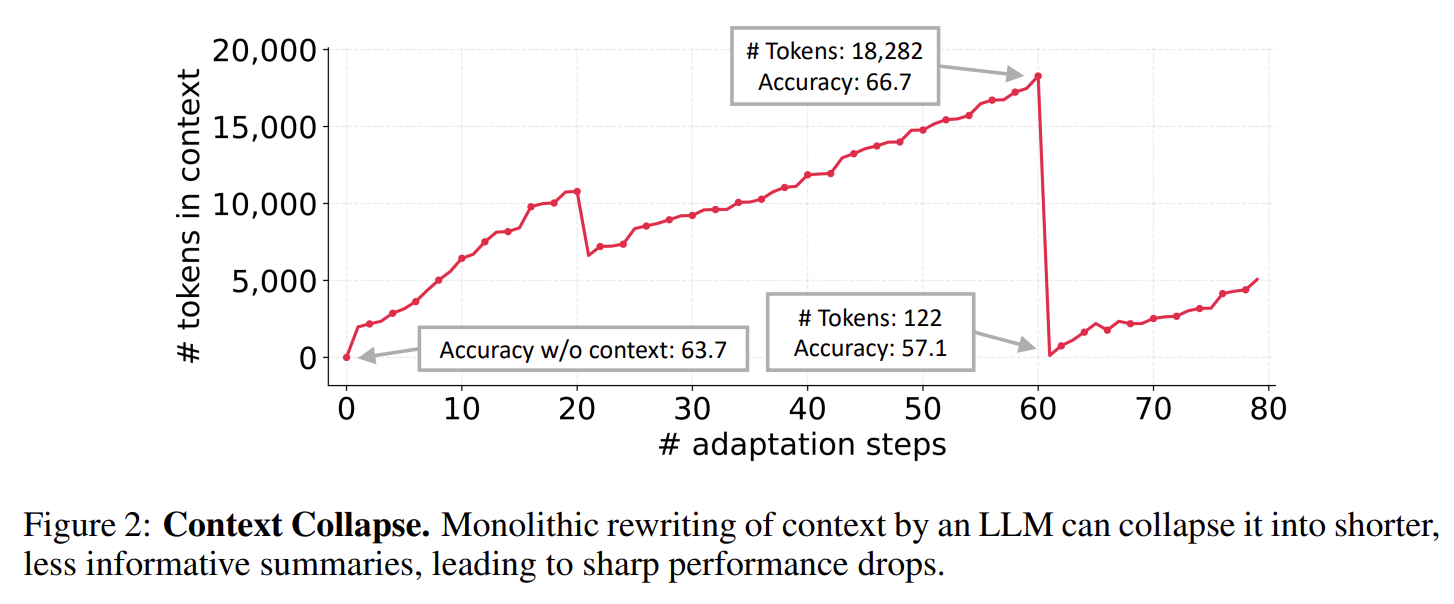
ACE(Zhang et al., ICLR 2026)는 다른 문제를 짚었습니다. 프롬프트를 통째로 다시 쓰게 하면 반복할수록 세부가 깎여 나가는데, 논문은 이 현상에 context collapse라는 이름을 붙였습니다. 그래서 ACE는 덮어쓰지 않고, Generator, Reflector, Curator 세 역할이 플레이북에 항목을 덧붙이고 정리합니다. 에이전트 벤치마크에서 +10.6%, 그러면서 새 태스크에 맞추는 데 드는 시간과 rollout 비용을 크게 줄였습니다. 여기서도 성능과 비용이 함께 좋아졌습니다.
메모리 layer의 MemEvolve(ICML 2026)는 메모리에 무엇을 넣을지가 아니라 인코딩·저장·검색·정리의 구조 자체를 진화시켜 기존 프레임워크를 최대 17.06% 개선했습니다.
Meta의 HyperAgents(Zhang et al., 2026)는 harness를 고치는 메커니즘까지 고치게 했습니다. 태스크를 푸는 에이전트와 그 에이전트를 수정하는 메타 에이전트를 하나의 편집 가능한 프로그램에 넣어, 메타 에이전트가 자기 자신도 수정할 수 있게 한 것입니다.
점수보다 눈에 띄는 것은 진화 과정에서 무엇이 만들어졌는가입니다. 논문 초록에 따르면 에이전트는 자기 개선 과정에서 persistent memory(영구 메모리)와 performance tracking(성능 추적) 같은 컴포넌트를 스스로 만들어 냈고, 이 개선은 도메인을 넘어 전이되고 실행을 거듭하며 누적됐습니다. persistent memory와 performance tracking은 지금 개발자들이 직접 만드는 바로 그 harness 컴포넌트입니다. 우리가 직접 만들던 harness는 개발자의 취향이 아니라, 진화가 도달하는 지점이었습니다.
앞의 세 layer가 잘 되면 프롬프트와 코드로 충분하지 않을까요?
마지막 layer는 harness를 밖에 두지 않고 모델 안에 넣습니다. EvoHarness-RL(Meta, 2026)은 외부 상태를 언제 읽고 갱신하고 정리할지를 Qwen3-8B에 RL로 학습시켜 ALFWorld에서 96.9%의 성능을 냈습니다. 논문은 harness annealing이라는 현상도 관찰했습니다. 훈련이 진행되면서 반복되는 harness 사용 패턴이 모델 policy 안으로 내재화되고, 외부 harness를 부르는 횟수가 줄어드는 현상입니다. 바깥에 있던 설계가 안으로 흡수되는 모습입니다.
policy layer가 필요한 이유는 Harness Updating Is Not Harness Benefit(Lin et al., 2026)에서 볼 수 있습니다. 이 논문은 좋은 harness 수정안을 만드는 능력과 진화된 harness에서 이득을 보는 능력을 분리해서 쟀습니다. 만드는 능력은 모델 등급과 거의 무관해서, 9B 모델의 수정안이 Claude Opus 4.6의 것과 비슷한 이득을 냈습니다. 반면 이득을 보는 능력은 등급에 따라 달라서, 약한 모델은 진화된 skill을 로드조차 못 하거나 로드해도 끝까지 따르지 않았습니다.
레시피를 못 따르는 요리사에게는 아무리 좋은 레시피도 소용없습니다. 프롬프트 형태의 harness가 소용없는 작은 모델에게는 harness 사용법 자체를 학습시켜 안에 넣는 수밖에 없고, 그것이 policy layer입니다. 진화시키는 쪽이 비용이 합리적인 모델이어도 된다는 것도 의미가 있는 부분이라고 볼 수 있겠습니다.
Meta-Harness는 self-evolving 루프를 어떻게 구현했을까?
Stanford IRIS Lab의 Meta-Harness(Lee, Nair, Zhang, Lee, Khattab, Finn, 2026)는 이름 그대로 harness를 고치는 harness입니다. 모델 가중치는 그대로 두고 모델을 감싸는 코드만 고치기 때문에, 파인튜닝이 불가능한 API 모델 환경에 바로 해당합니다.
Loop는 어떻게 돌아갈까?
Loop는 단순합니다. 지금까지 시도한 모든 harness 후보의 소스 코드, 평가 점수, 실행 기록을 파일시스템에 쌓아 둡니다. 코딩 에이전트(Claude Code)가 그 파일시스템을 grep과 cat으로 읽으며 필요한 것만 골라 보고 새 harness를 제안하면, 평가 결과가 다시 파일시스템에 쌓이고 루프가 반복됩니다. 사람이 준 것은 초기 harness와 평가 기준, 그리고 정확도와 컨텍스트 비용을 함께 보라는 선호뿐입니다. 한 번의 평가가 만들어내는 진단 정보는 최대 1,000만 토큰에 이르는데, 그걸 한 프롬프트에 전부 넣는 대신 필요한 것만 찾아 읽는 구조입니다.
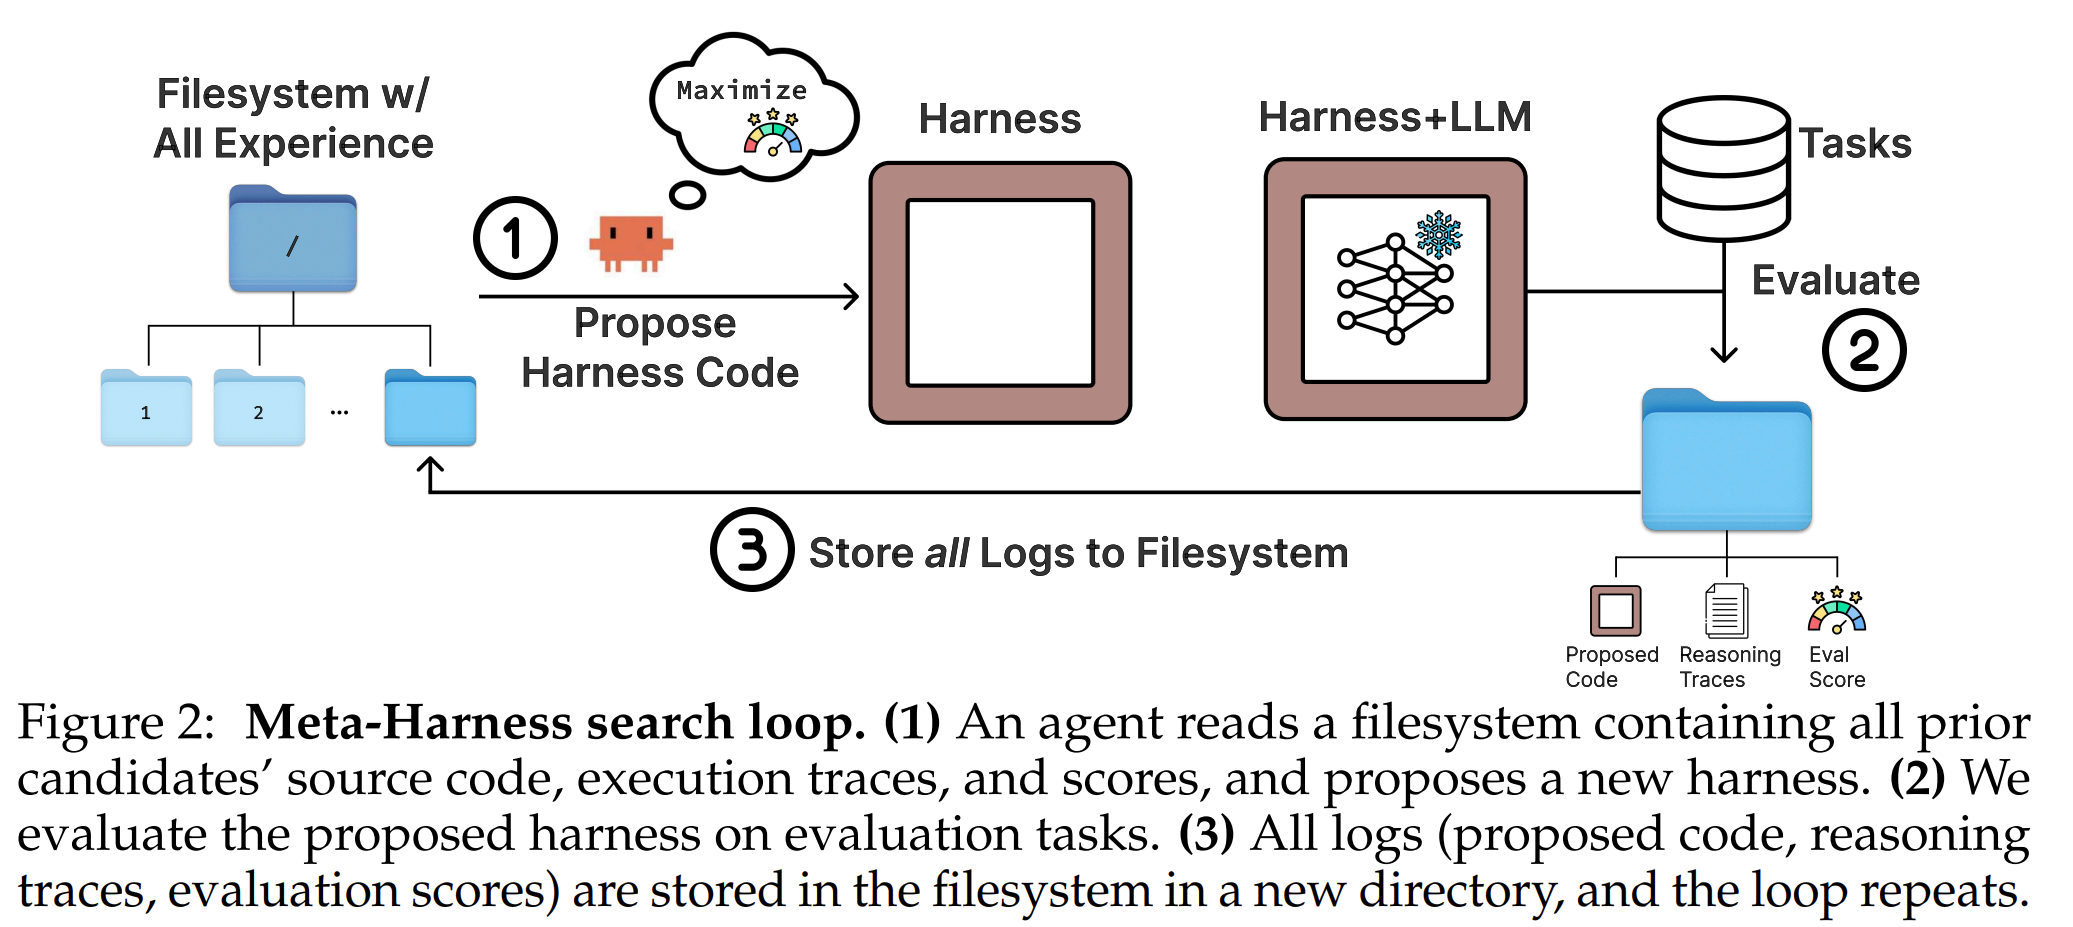
이전 시도들의 원본 기록을 파일시스템에 두고, 제안 에이전트(proposer)가 필요한 것만 찾아 읽습니다.
진화된 harness는 실제로 어떻게 생겼을까?
Meta-Harness 프로젝트 페이지의 인터랙티브 데모에서 작은 탐색 한 번을 통째로 볼 수 있습니다. 에이전트들이 유난히 못 푸는 터미널 태스크 19개만 골라 가장 성능이 좋은 기존 harness(28.5%)에서 시작했더니, 7번 반복 만에 46.5%가 됐고 모델은 한 번도 바뀌지 않았습니다. 반복을 하나씩 넘겨 보면 제안 에이전트는 여러 실행 기록을 나란히 놓고 어떤 수정이 어떤 실패를 불렀는지 따지고, 원본 로그에서 구체적인 실패 패턴을 찾아 그 패턴만 겨냥한 수정을 냅니다. 사람 엔지니어가 포스트모템에서 하는 일을 그대로 하되, 밤새 수십 번 합니다.
성능과 토큰은 어떻게 달라졌을까?
- 온라인 텍스트 분류(데이터가 순서대로 들어오는 스트리밍 세팅): 기존 컨텍스트 관리 방법 중 가장 성능이 좋은 ACE 대비 +7.7pt, 컨텍스트 토큰은 1/4.
- 터미널 작업 벤치마크(TerminalBench-2): 사람이 직접 만든 최고 harness들을 넘어, 같은 모델(Haiku 4.5)을 쓰는 에이전트 중 1위.
- 수학 문제용 검색 harness: 탐색 때 쓰지 않은 모델 5개에 옮겨도 평균 +4.7pt. 특정 모델에만 통하는 트릭이 아니라는 뜻입니다.
온라인 텍스트 분류 도메인의 결과를 보면 알 수 있듯이, 성능과 토큰 비용은 트레이드오프가 아니었습니다. 사람의 개입이 빠졌더니 둘 다 좋아졌습니다.
Meta-Harness는 왜 작동할까?
논문은 제안 에이전트에게 무엇을 보여주느냐만 바꾼 ablation을 실었습니다. 점수만 줬을 때 중앙값 정확도 34.6, 점수에 LLM이 쓴 요약을 더했을 때 34.9, 원본 실행 기록 전체를 줬을 때는 그보다 큰 격차로 높습니다. 요약을 줘도 점수만 준 것과 거의 같고, 원본이어야 격차가 벌어집니다.
왜 그럴까요? harness는 긴 시간에 걸쳐 작동합니다. 무엇을 저장할지, 언제 꺼낼지에 대한 한 번의 선택이 수십 단계 뒤의 행동을 바꾸는데, 요약은 그 인과의 사슬을 끊어 버립니다. 포스트모템 문서 없이 결과 숫자만 보고 프로세스를 고치라는 것과 같습니다. "요약하되 원본을 버리지 마라"가 진화에서도 똑같이 작동합니다. Karpathy의 autoresearch(2026.03)가 같은 루프를 연구 코드에 돌리면서 git 히스토리를 아카이브로 쓴 것도 같은 원리입니다.
에이전트가 스스로 좋아질 수 있는 이유는, 요약된 점수가 아니라 실패의 원본 기록을 보기 때문입니다.
Self-evolving agent는 이미 상품화 되었나? OpenAI와 Anthropic 사례
금요일마다 사람이 치우던 OpenAI의 일은 결국 이렇게 바뀌었습니다. 지켜야 할 원칙을 레포에 적어 넣고, 백그라운드 에이전트가 그 원칙에서 벗어난 코드를 찾아 고치는 PR을 여는 루프로 대체한 것입니다. 최초의 AGENTS.md도 Codex가 썼고, 낡은 문서를 찾아 수정 PR을 여는 "doc-gardening" 에이전트가 주기적으로 돕니다. 문서와 규칙, 즉 harness의 유지보수를 에이전트에게 맡긴 실제 운영 사례입니다. 사람은 이제 다른 layer에서 일한다고 OpenAI는 씁니다.
한 layer 더 깊이 넘긴 것이 Anthropic(2026.06)의 dynamic workflows입니다. Claude가 작업마다 오케스트레이션 코드를 직접 짜서 서브에이전트를 띄우고 검증 에이전트를 붙입니다. 다만 이 방식은 세션 토큰이 오히려 늘어납니다. 토큰 절감은 사전에 진화시킨 harness를 쓸 때 나타나는 것이고, 실행 중에 즉석으로 harness를 생성하는 것과는 다른 이야기입니다.
Anthropic Claude Code 팀(2026.06)의 가이드에는 눈여겨볼 권고가 하나 있습니다. 루프의 결과가 기준에 못 미치면 그 건만 고치지 말고 원인을 시스템에 새겨 넣어 이후 모든 반복이 좋아지게 하라는 것입니다. 실패를 harness에 반영하는 이 마지막 단계는 아직 사람이 직접 하고, self-evolving이 자동화하려는 것이 정확히 이 단계입니다.
정리하면 프롬프트/문서 layer와 harness 코드 layer는 제품에 들어왔고, 메모리 구조와 policy layer는 아직 학계에 머물러 있습니다. 그런데 Industry에서 하는 건 한 세션, 또는 한 레포 안의 일입니다. 태스크가 끝없이 들어오는 운영 환경에서 몇 달씩 계속 진화시키려면 무엇이 더 필요할까요.
AI 에이전트에게 개선을 맡기려면 무엇이 필요할까?
앞에서 본 연구 대부분은 고정된 벤치마크에서 한 번 최적화한 것입니다. 운영에서는 harness가 계속 현재 상태를 반영하지 못하고 해당 시점부터 점점 오래된 상태가 되는것이 문제입니다. 이 갭을 정면으로 짚은 것이 Amazon과 Emory의 Adaptive Auto-Harness(Liu et al., 2026)입니다. 실제 배포는 태스크가 끝없이 들어오는 스트림이고 분포는 계속 바뀌는데, 그 위에서 하나의 harness를 계속 조밀하게 업데이트하면 정확도가 초반에 정점을 찍고 하락합니다.
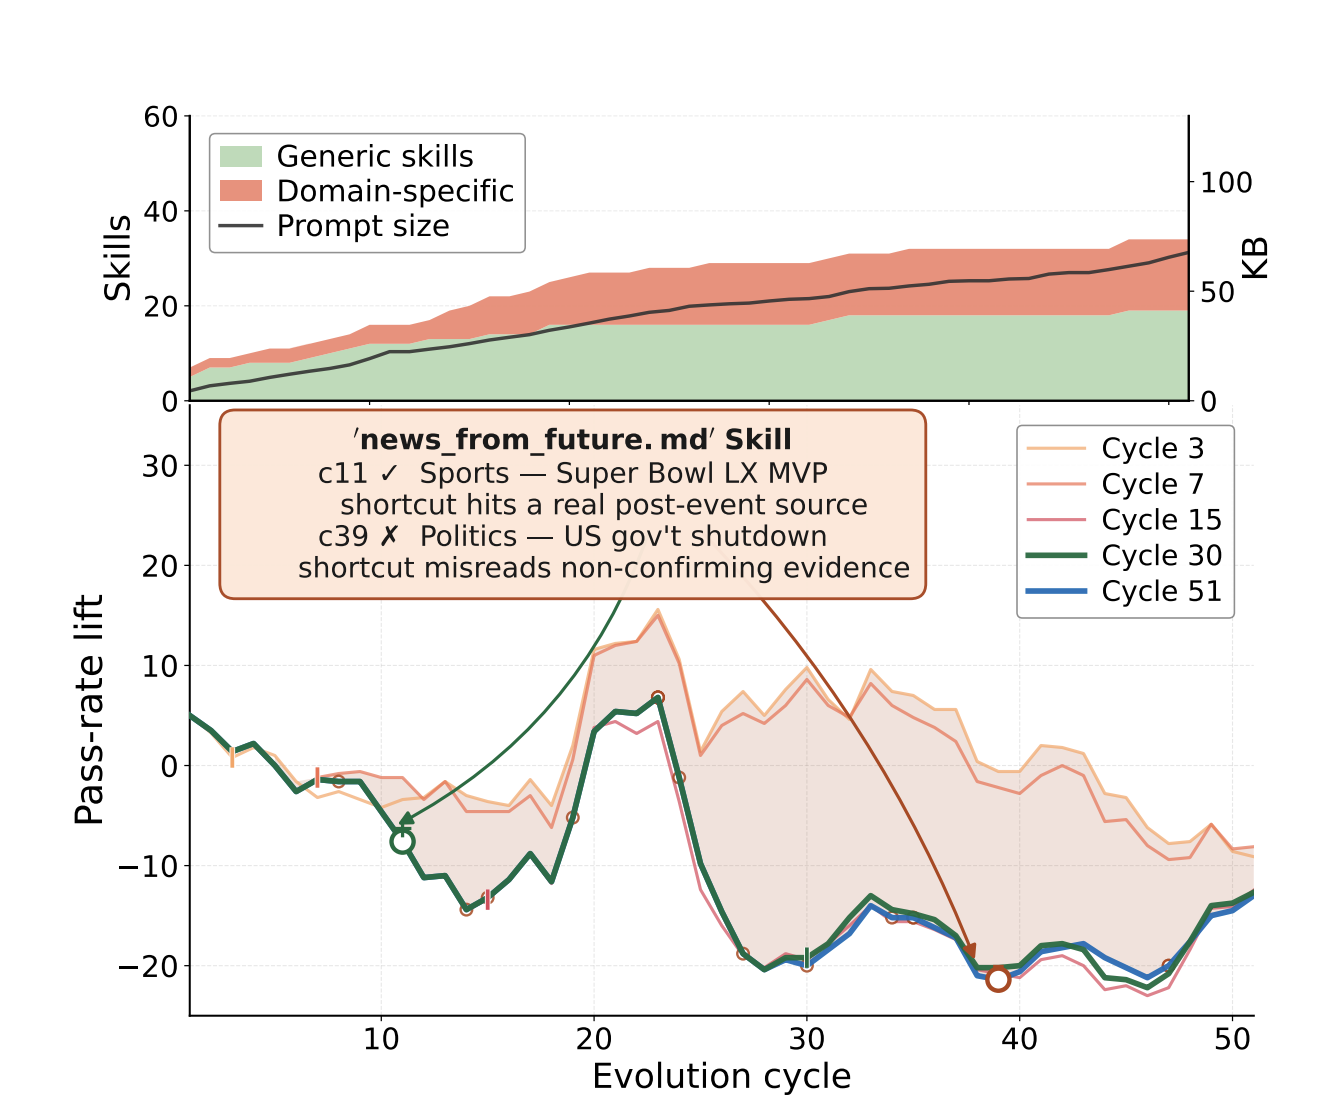
실행 기록이 없으면 왜 진화도 없을까?
AHE(Lin et al., 2026)는 원본 기록을 observability라는 이름으로 설계에 포함했습니다. harness의 모든 컴포넌트와 실행 기록을 파일로 남기고, 모든 수정에 어떤 실패 증거를 보고 무엇을 고쳤는지를 짝지었습니다. 그런데 많은 팀이 에이전트 실행 기록을 버립니다. 응답은 저장해도 중간의 도구 호출과 실패는 남기지 않는 경우가 흔합니다. 로그가 없으면 맡길 수도 없습니다.
진화 루프에서 Goodhart의 법칙은 어떻게 나타날까?
진화 루프는 주어진 지표를 올리는 것밖에 못 합니다. 지표가 목표가 되는 순간 harness는 평가셋에 과적합되고, 벤치마크 점수는 오르는데 실제 업무에서는 나빠지는 일이 생깁니다. Lilian Weng도 자기 진화의 미해결 과제로 빠르고 정확한 Validator가 없는 태스크가 대부분이라는 점과 reward hacking을 꼽습니다.
맡길 때 사람이 주는 "목표"의 실체가 바로 이 평가 기준입니다. Claude Code의 /goal이 좋은 예입니다. 에이전트가 멈추려 할 때마다 평가 모델이 사람이 준 조건을 검사해 되돌려 보내는데, 팀은 통과한 테스트 수나 Lighthouse 90점처럼 기계적으로 판정되는 기준이 효과적이라고 씁니다. 기준이 모호하면 에이전트가 "이 정도면 됐다"를 스스로 판단하고 일찍 멈춥니다.
잘못된 방향으로 진화하면 어떻게 막을까? misevolution
Your Agent May Misevolve(Shao et al., ICLR 2026)는 에이전트가 스스로 진화하다 잘못된 방향으로 가는 현상에 misevolution이라는 이름을 붙였습니다. 한 예로 코딩 워크플로를 성능 기준으로 자동 최적화했더니, 안전 벤치마크에서 위험한 요청을 거부하는 비율이 46.3%에서 6.3%로 떨어졌습니다. 아무도 나쁜 의도를 넣지 않았는데도 그렇게 된 것은, 지표에 안전이 없었기 때문입니다.
그래서 게이트가 필요합니다. Claude Code 팀의 표현을 빌리면 코드를 쓰는 루프에는 그것을 검사하는 루프가 따로 필요합니다. Self-Harness(Zhang et al., 2026)는 진화에 쓴 데이터와 쓰지 않은 데이터 양쪽 모두에서 성능 하락이 없을 때만 수정을 받아들입니다. Weng은 평가기와 권한 통제는 진화 루프 바깥에 있어야 한다고 말하고 있습니다.
기록, 기준, 게이트. 이 셋의 공통점은 전부 에이전트가 아니라 사람이 공급하는 것이라는 점입니다. Adaptive Auto-Harness가 실행 기록에 답이 없을 때 사람이 방향을 주는 훅을 설계에 넣어 둔 이유도 이것입니다. 맡긴다는 것은 개입을 없애는 것이 아닙니다.
AI 에이전트에게 다 맡기면 사람의 역할은 무엇이 될까?
Evolving의 발전 단계를 다시 보면, 각 단계는 병목이 풀리자 다음 병목이 드러난 기록이었습니다. 다섯 번째 단계는 self-evolving이고, 사전에 진화시킨 harness를 쓰는 한 앞 단계들의 패턴은 여기서도 반복됐습니다. 제목의 질문에 답하면 에이전트는 스스로 진화할 수 있습니다. 그러면 harness를 만드는 일은 더 이상 병목이 아니고, 남는 것은 둘입니다.
첫째, 무엇이 '더 나은 것'인지 정하는 일. 진화 루프는 평가 기준이 가리키는 방향으로만 갑니다. 만드는 일이 자동화되면 평가 기준을 설계하는 일이 시스템의 방향을 정하는 유일한 수단이 됩니다. Addy Osmani(2026.07)는 후속 글에서 이것을 outer loop라고 부릅니다. 에이전트는 실행의 inner loop를 돌리고, 엔지니어는 어떤 검증을 걸지와 무엇을 통과시킬지를 정하는 outer loop를 소유한다는 것입니다.
둘째, 진화된 harness가 모델로 흡수되는 순환. EvoHarness-RL의 harness annealing에서 본 것처럼 바깥에 있던 harness는 학습을 거치며 모델 안으로 들어갑니다. Weng은 harness 개선의 상당수가 결국 모델 행동에 내재화되겠지만, 프롬프트 엔지니어링이 그랬듯 목표와 제약과 평가를 명시할 필요는 사라지지 않을 것이라고 씁니다. 어차피 모델이 흡수할 텐데 왜 진화시키냐고 물을 수 있습니다. 진화 루프가 만든 harness는 다음 세대 모델의 학습 재료가 되고, 흡수되고 나면 진화의 대상은 더 어려운 문제로 옮겨갑니다. 진화 루프가 유지하는 것은 특정 harness가 아니라 지금 무엇이 부족한지 찾아내는 능력입니다.
맡긴다는 것은 사람이 관여하는 layer를 한 단계 올리는 것입니다. 세 출처가 서로 다른 말로 같은 얘기를 합니다.
- OpenAI: 우선순위를 정하고, 피드백을 수용 기준으로 번역하고, 결과를 검증한다
- Osmani: outer loop를 소유한다
- Weng: "Humans should move up the stack, not be removed from the loop"
프롬프트를 쓰는 사람에서 무엇이 더 나은지를 정하는 사람으로. 오늘의 블로그 글을 한 줄로 요약하면 이렇게 표현할 수 있겠습니다.
시키는 시대에는 사람이 답을 썼고, 맡기는 시대에는 사람이 무엇이 더 나은지를 씁니다.
참고 문헌
- OpenAI. (2026). Harness engineering: leveraging Codex in an agent-first world
- Anthropic. (2026). Loop engineering: Getting started with loops
- Anthropic. (2026). A harness for every task: dynamic workflows in Claude Code
- Cursor. Dynamic context discovery
- Osmani, A. (2026). Loop Engineering
- Osmani, A. (2026). Own the Outer Loop
- Weng, L. (2026). Harness Engineering for Self-Improvement
- Karpathy, A. (2026). autoresearch
- Agrawal, L. A. et al. (2026). GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning
- Zhang, Q. et al. (2026). Agentic Context Engineering: Evolving Contexts for Self-Improving Language Models
- Zhang, G. et al. (2026). MemEvolve: Meta-Evolution of Agent Memory Systems
- Zhang, J. et al. (2026). Hyperagents
- Meta AI. (2026). EvoHarness-RL: Learning Self-Evolving Runtime Harness for Long-Horizon LLM Agents
- Lin et al. (2026). Harness Updating Is Not Harness Benefit: Disentangling Evolution Capabilities in Self-Evolving LLM Agents
- Lee, Y. et al. (2026). Meta-Harness: End-to-End Optimization of Model Harnesses
- Liu et al. (2026). Adaptive Auto-Harness: Sustained Self-Improvement for Agentic System Deployment on Open-Ended Task Streams
- Lin et al. (2026). Agentic Harness Engineering: Observability-Driven Automatic Evolution of Coding-Agent Harnesses
- Zhang et al. (2026). Self-Harness: Harnesses That Improve Themselves
- Shao, S. et al. (2026). Your Agent May Misevolve: Emergent Risks in Self-evolving LLM Agents