AI Insight
AI가 검색하는 시대, 검색 인터페이스가 바뀌고 있다
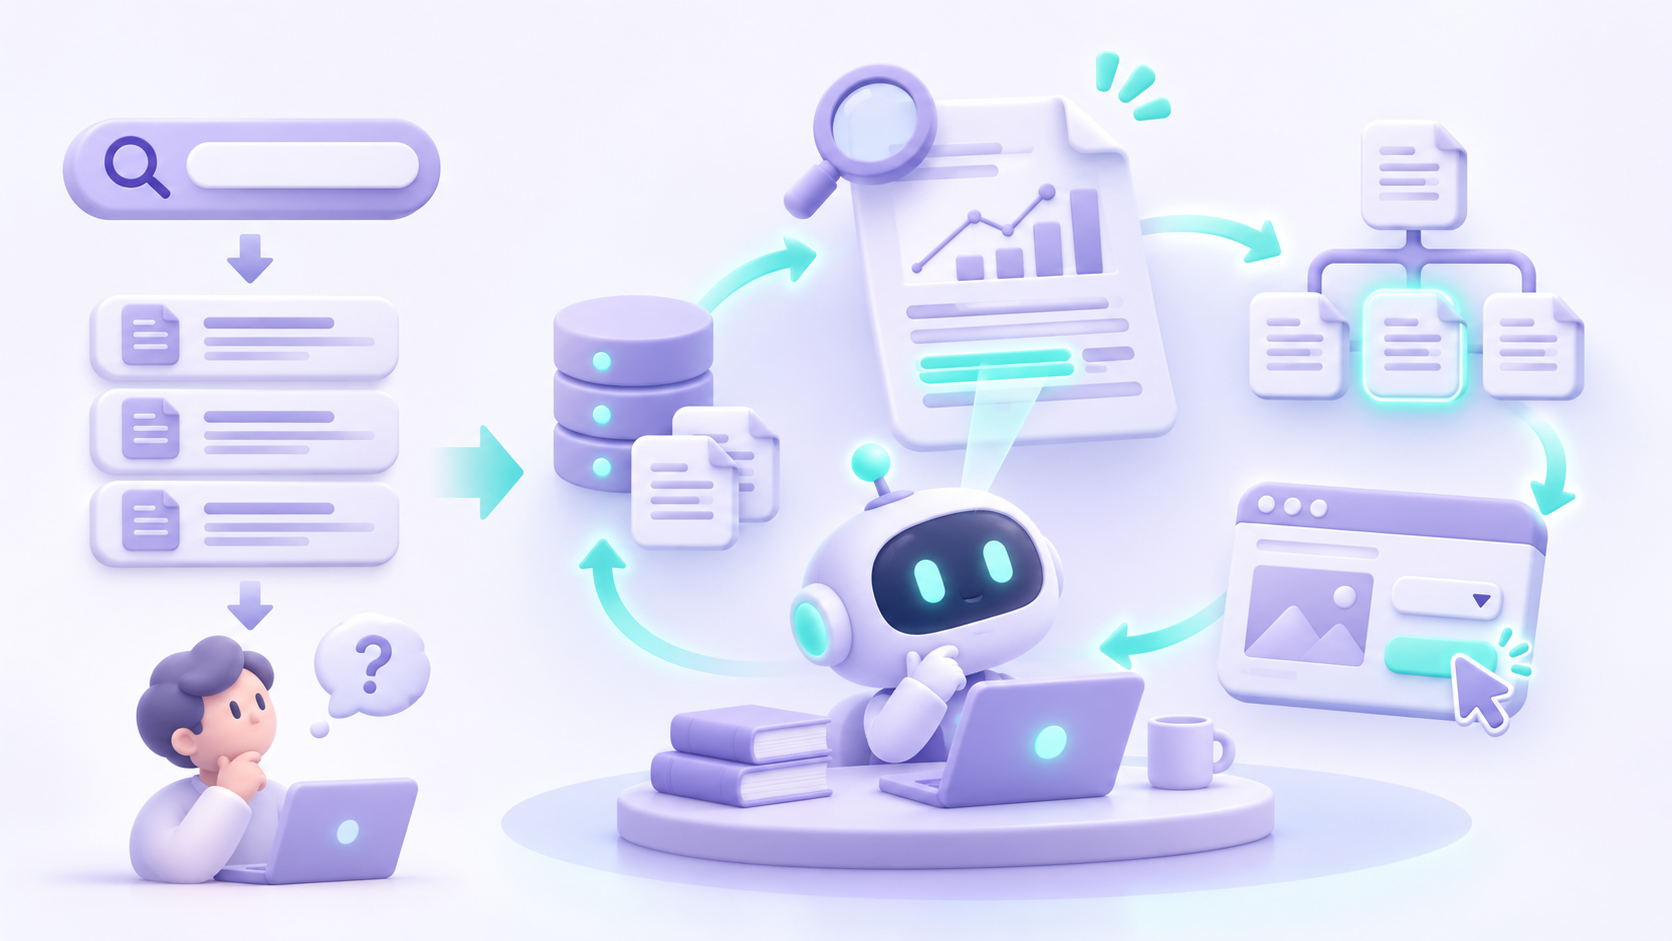
AI에게 다음과 같은 조사를 부탁했다고 생각해보겠습니다.
“최근 5년간 국내 주요 도시의 공공자전거 이용량이 어떻게 달라졌는지 조사해줘. 관련 정책이 바뀐 시점도 함께 확인하고, 공식 자료를 근거로 도시별 변화를 비교해줘.”
검색을 시작하면 여러 자료가 나옵니다. 지자체의 운영 보고서, 연도별 이용 통계, 정책 발표 자료, 관련 기사 등이 있습니다.
하지만 이 자료들을 찾았다고 해서 바로 답할 수 있는 것은 아닙니다. 어떤 보고서에는 연도별 대여 건수가 있고, 다른 자료에는 정책 시행 시점만 나와 있습니다. 같은 이용량을 다루더라도 집계 기준이 다를 수 있고, 일부 수치는 표 안에, 중요한 설명은 각주에 적혀 있을 수도 있습니다.
제대로 조사하려면 관련 자료를 찾아 읽고, 새로운 단서를 발견하면 다시 검색해야 합니다. 서로 다른 문서에서 얻은 정보를 연결하고, 수치가 일치하지 않으면 원문으로 돌아가 확인하는 과정도 필요합니다.
최근 AI 에이전트가 수행하는 딥리서치(Deep Research)는 이러한 과정을 잘 보여줍니다. 에이전트는 하나의 질문에 답하기 위해 여러 출처를 탐색하고, 중간에 발견한 정보를 바탕으로 다음 검색을 결정합니다. 이 과정에서 검색은 한 번 수행하고 끝나는 작업이 아니라, 조사 전반에 걸쳐 반복적으로 이루어지는 활동이 됩니다.
그런데 기존 검색 시스템은 이러한 탐색 과정을 충분히 지원하도록 설계되어 있지는 않습니다.
전통적인 검색 시스템은 질의와 관련성이 높은 문서를 순위화하고, 상위 몇 개의 결과를 반환하는 데 초점을 맞춥니다. 반면 에이전트는 특정 표현이 포함된 부분을 직접 확인하거나, 여러 조건을 만족하는 문서들을 비교하고 싶을 수 있습니다. 이미 찾은 자료를 유지하면서 다른 방향으로 탐색하거나, 웹페이지에서 필요한 정보를 얻기 위해 직접 행동해야 할 때도 있습니다.
즉, 사람에게 검색 결과가 최종적으로 전달받는 정보였다면, 에이전트에게는 다음에 무엇을 할지 결정하기 위한 중간 결과가 되는 것입니다.
이러한 변화에서 주목할 부분이 바로 검색 인터페이스(Search Interface)입니다.
검색 인터페이스는 단순히 검색창의 모양을 뜻하지 않습니다. 에이전트가 외부 정보에 접근하기 위해 어떤 동작을 요청할 수 있고, 그 결과로 무엇을 돌려받는지를 결정하는 방식입니다.
같은 모델과 같은 자료를 사용하더라도, 어떤 동작을 허용하는지에 따라 에이전트가 발견할 수 있는 근거와 탐색 과정은 달라질 수 있습니다. 이는 결국 사용자가 요청한 작업을 얼마나 정확하게 수행할 수 있는지에도 영향을 미칩니다.
최근에는 이러한 관점에서 검색 인터페이스를 다시 설계하려는 연구들이 등장하고 있습니다.
검색 결과를 받는 대신, 원문에서 직접 찾아보기
먼저 앞서 살펴본 공공자전거 이용량 조사로 돌아가 보겠습니다.
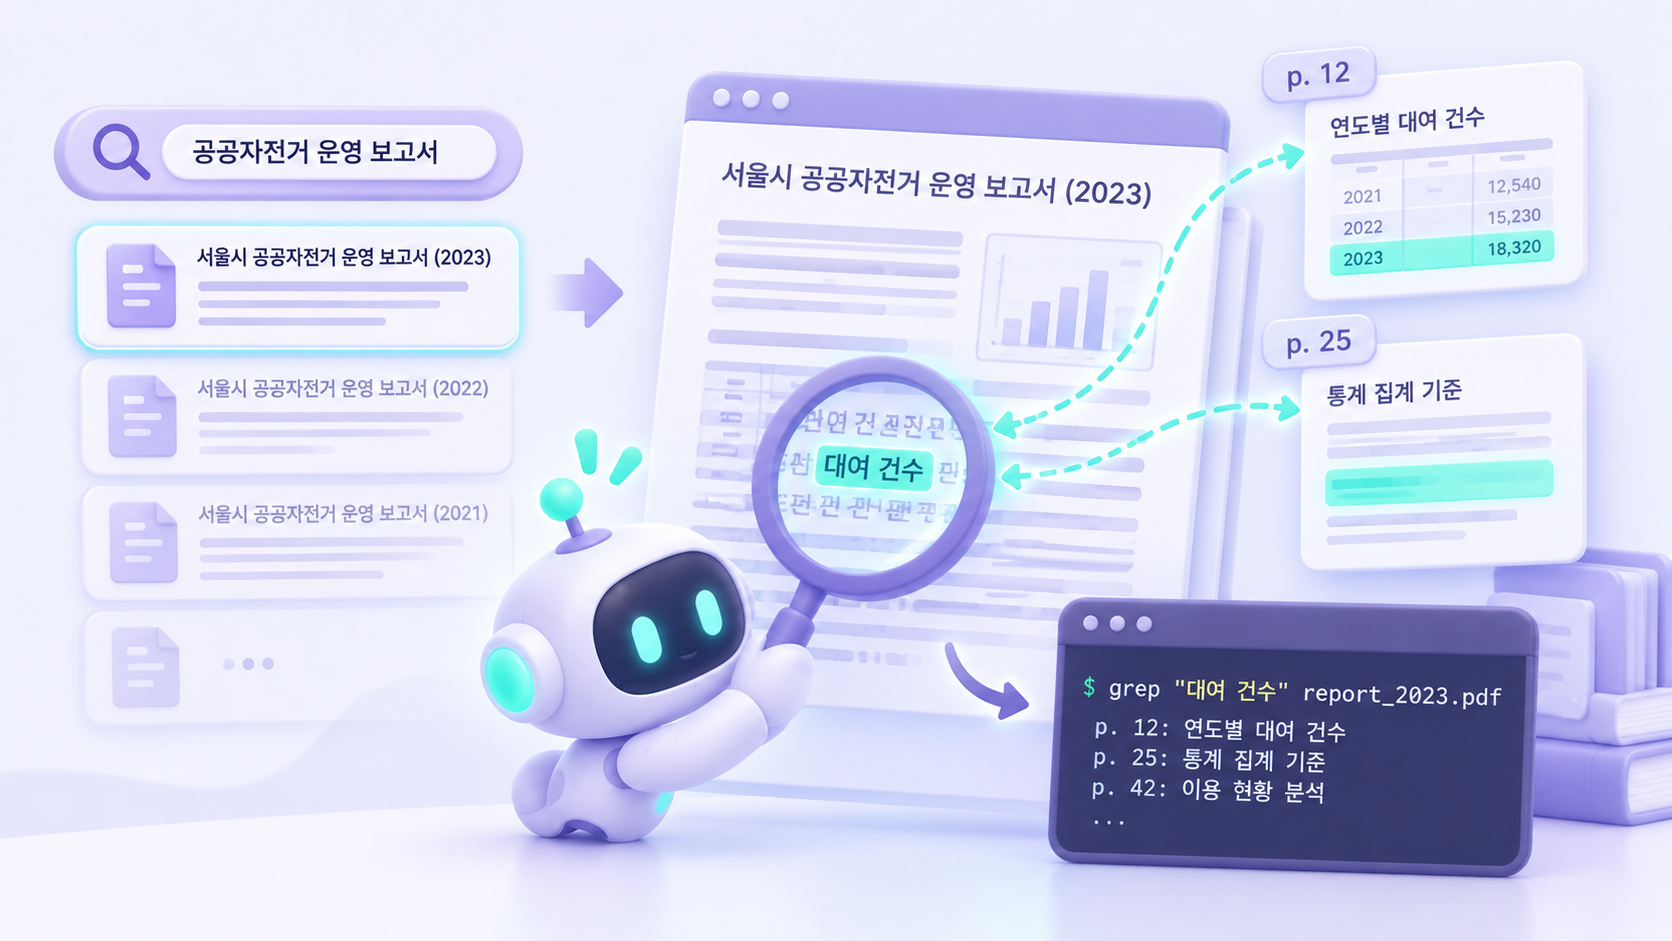
에이전트가 특정 도시의 운영 보고서를 찾았다고 해보겠습니다. 보고서에는 이용량과 관련된 여러 통계가 포함되어 있지만, 검색 결과로 반환된 문단에는 원하는 연도의 수치가 빠져 있을 수 있습니다. 정확한 집계 기준이나 예외 사항이 다른 페이지에 설명되어 있을 수도 있습니다.
이때 에이전트에게 필요한 것은 새로운 문서를 찾는 일이 아니라, 이미 찾은 문서에서 원하는 근거를 확인하는 일입니다.
예를 들어 보고서에서 '대여 건수'라는 표현이 등장하는 위치를 찾고, 그 주변 문장을 읽어볼 수 있습니다. 원하는 수치를 발견했다면 같은 문서에서 집계 기준에 관한 설명을 추가로 확인할 수도 있습니다.
이를 위해 반드시 새로운 검색 질의를 만들어 관련 문서를 다시 받아야 하는 것은 아닙니다. 에이전트가 원문에 직접 접근할 수 있다면, 필요한 부분을 찾아 읽으며 조사를 이어갈 수 있습니다.
DCI(Direct Corpus Interaction)는 이러한 접근을 제안합니다.
DCI에서는 에이전트가 원본 문서 집합(Corpus)에 직접 접근하고, grep, 파일 읽기, 셸 명령 등의 범용 도구를 조합해 자료를 탐색합니다. 임베딩 모델이나 벡터 인덱스를 통해 검색 결과를 미리 추려주는 대신, 에이전트가 검색 조건을 직접 적용하고 관련 문맥을 읽어 판단하도록 합니다.
이는 코딩 에이전트가 코드베이스에서 필요한 함수를 찾아가는 과정과 비슷합니다. 특정 함수의 정의를 찾고, 주변 코드를 읽고, 다른 파일에서 해당 함수가 어떻게 사용되는지 추적하는 방식입니다. 문서 탐색에서도 마찬가지로, 하나의 단서에서 출발해 관련 표현을 찾고 필요한 부분을 선택적으로 읽을 수 있습니다.
이러한 방식에서는 에이전트가 현재 무엇을 확인해야 하는지에 따라 탐색 동작을 선택합니다. 원하는 표현이 실제로 등장하는지 확인하거나, 특정 문장의 주변 문맥을 읽고, 새롭게 발견한 단서로 다른 문서까지 조사할 수 있습니다.
DCI가 보여주는 것은 검색 성능이 반드시 더 좋은 검색 모델에서만 나오는 것은 아니라는 점입니다. 모델이 자료를 얼마나 자유롭고 세밀하게 탐색할 수 있는지도 중요합니다.
그런데 원문을 직접 살펴볼 수 있게 되었다고 해서 모든 문제가 해결되는 것은 아닙니다. 자료가 많아질수록 어느 문서부터 읽어야 할지 결정하는 일 자체가 어려워지기 때문입니다.
원문을 읽기 전에, 검색 후보를 다룰 수 있다면
공공자전거 관련 보고서가 수만 건 있다고 가정해보겠습니다.
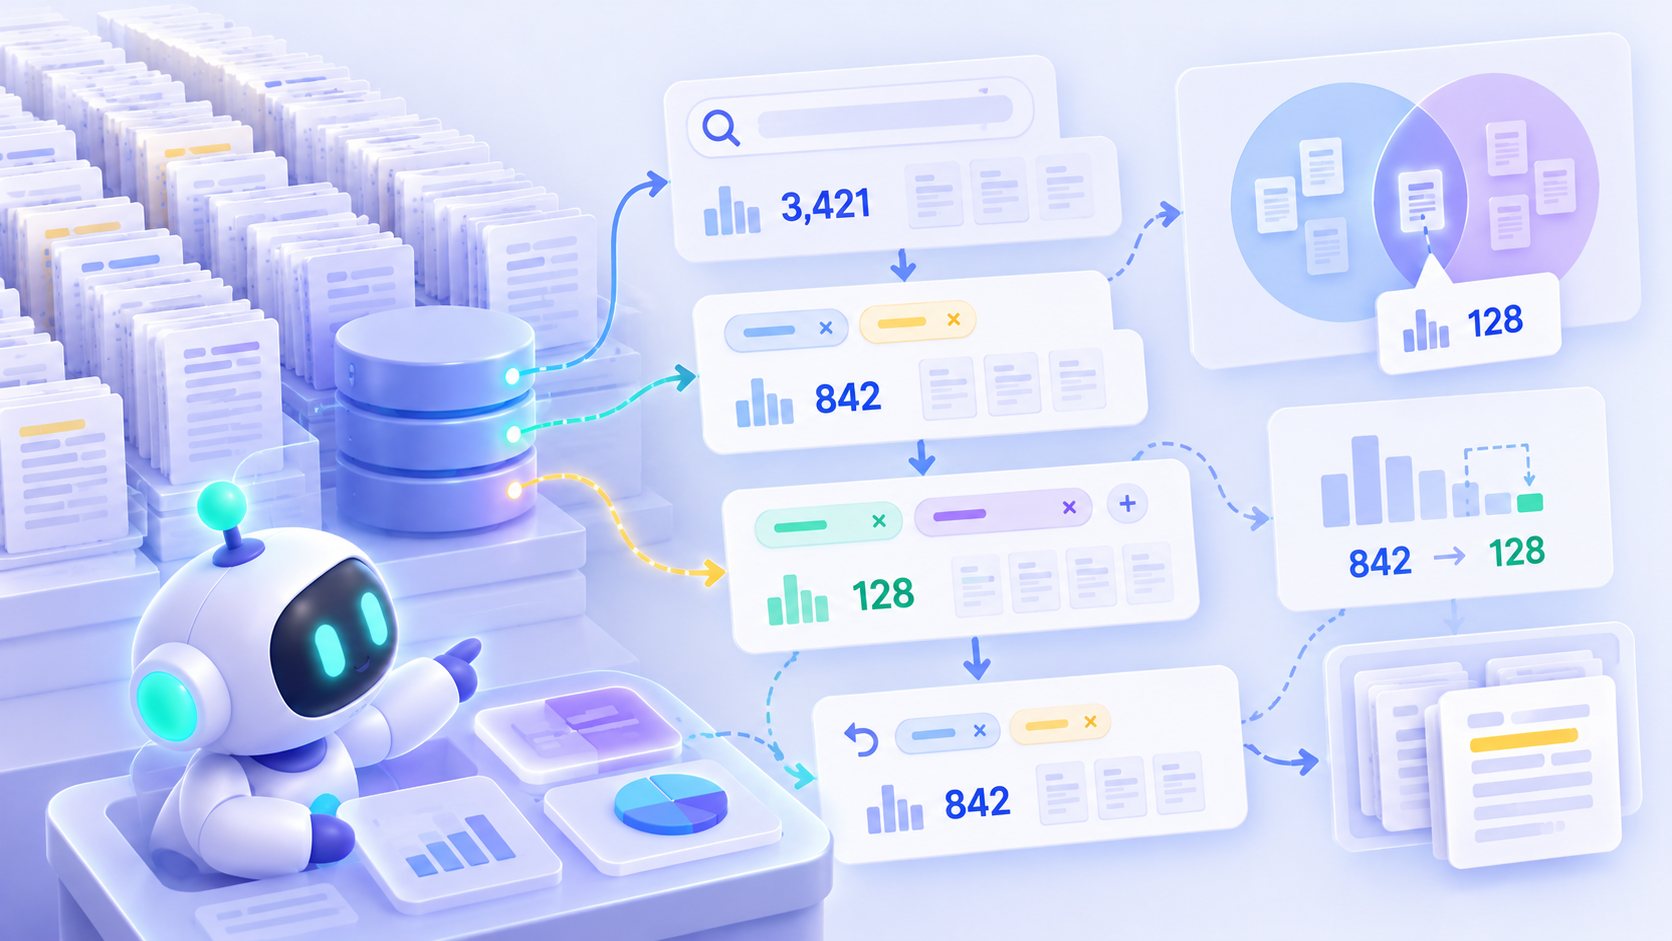
에이전트는 특정 도시의 이용량을 조사하기 위해 관련 자료를 찾아야 합니다. 하지만 모든 보고서를 하나씩 열어볼 필요는 없습니다. 먼저 해당 도시와 관련된 문서가 얼마나 있는지 확인하고, 여기에 연도나 통계 항목 등의 조건을 추가하면서 조사할 범위를 좁힐 수 있을 것입니다.
이 과정에서는 문서의 내용보다 먼저 확인하고 싶은 정보가 있습니다.
특정 조건을 만족하는 문서가 얼마나 있는지, 새로운 조건을 추가했을 때 후보가 얼마나 줄어드는지, 서로 다른 조건으로 찾은 후보들이 얼마나 겹치는지에 관한 정보입니다.
이런 정보는 반드시 원문을 읽어야만 얻을 수 있는 것은 아닙니다. 검색 인덱스(Index)를 활용하면 문서 본문을 읽지 않고도 여러 검색 조건에 해당하는 후보를 찾을 수 있습니다.
예를 들어 역색인(Inverted Index)은 어떤 단어가 어느 문서에 등장하는지를 기록합니다. 이를 이용하면 특정 표현을 포함하는 문서집합을 구하고, 여러 조건을 조합해 후보를 좁힐 수 있습니다.
IndexAct는 이러한 인덱스 연산을 에이전트가 직접 활용하도록 설계된 검색 인터페이스입니다.
에이전트는 특정 표현을 포함하는 문서들로 후보집합을 만들고, 다른 조건을 적용해 범위를 좁히거나, 여러 후보집합의 합집합과 교집합을 구할 수 있습니다.
여기서 중요한 특징은 검색 결과를 매번 문서 본문으로 반환하지 않는다는 점입니다. IndexAct는 후보집합의 크기와 해당 집합을 다시 사용할 수 있는 참조를 제공하며, 에이전트는 필요한 시점에만 원문을 요청해 읽습니다.
앞선 조사에서도 이러한 방식을 활용할 수 있습니다.
먼저 특정 도시를 다룬 보고서들을 하나의 후보집합으로 확보합니다. 이후 '대여 건수', '운영 실적' 등의 표현을 포함하는 문서들로 범위를 좁힐 수 있습니다. 조건을 추가했는데 후보가 하나도 남지 않는다면, 이전 집합으로 돌아가 다른 표현을 적용할 수도 있습니다.
문서를 읽다가 새로운 사업명이나 관련 기관명을 발견했다면, 그 이름으로 별도의 후보집합을 만들고 기존 후보와 결합할 수도 있습니다.
여기서 핵심은 탐색 중간에 만들어진 후보집합을 유지하고 다시 활용할 수 있다는 점입니다.
일반적인 검색에서는 새로운 질의를 입력하면 그에 따른 새로운 결과가 반환됩니다. 반면 IndexAct에서는 이전에 확보한 후보를 기반으로 여러 조건을 시도하고, 필요하면 이전 상태로 돌아가 다른 방향의 탐색을 이어갈 수 있습니다.
또한 후보를 좁히는 과정과 실제 근거를 읽는 과정이 분리되므로, 단순히 검색 조건을 확인하기 위해 매번 긴 본문을 모델에 전달할 필요도 없습니다.
물론 인덱스에서 특정 표현이 발견됐다는 것만으로 그 문서가 올바른 근거라는 뜻은 아닙니다. 에이전트는 후보를 충분히 좁힌 뒤 필요한 원문을 확인하고, 그 과정에서 얻은 정보를 다시 탐색에 활용할 수 있습니다.
DCI가 원문을 직접 탐색하는 방법에 주목했다면, IndexAct는 원문을 읽기 전 단계에서 검색 후보 자체를 탐색하고 관리하는 방법에 주목합니다.
두 연구는 서로 다른 접근을 취하지만, 공통적으로 에이전트가 검색 결과를 수동적으로 받아들이는 대신 직접 탐색 과정을 구성할 수 있도록 합니다.
웹에서는 정보를 찾는 일과 행동하는 일이 연결된다
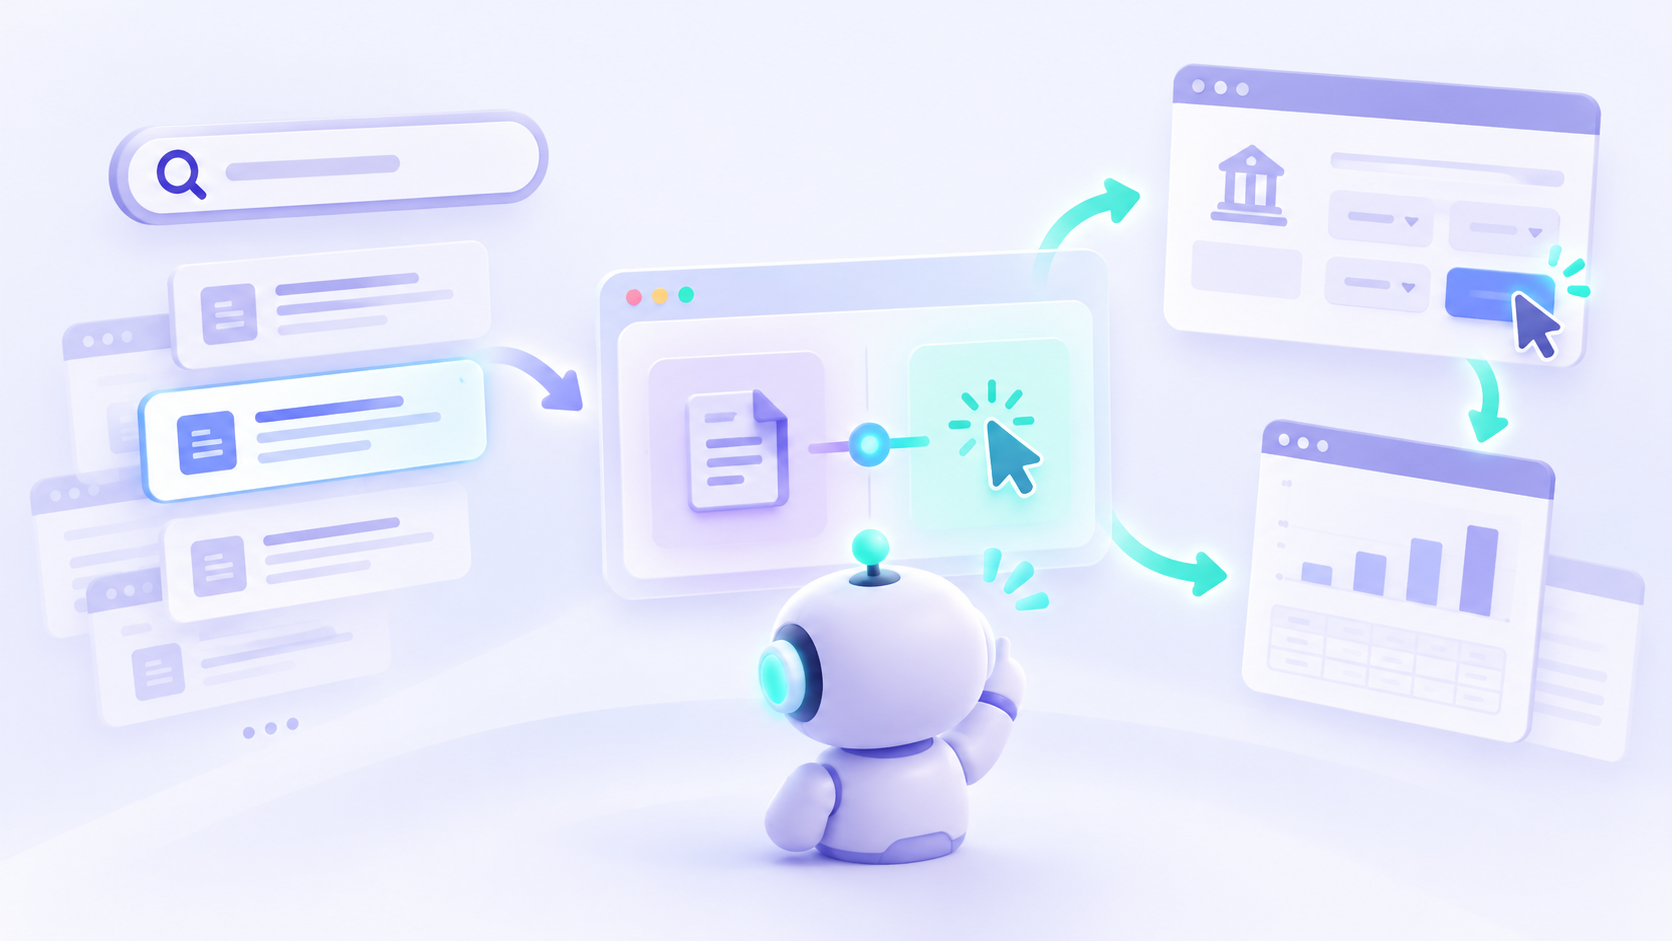
지금까지는 문서 집합 안에서 필요한 근거를 찾는 과정을 살펴봤습니다.
하지만 실제 딥리서치에서는 모든 정보가 미리 확보된 문서에 들어 있지는 않습니다. 필요한 자료가 여러 웹사이트에 흩어져 있고, 때로는 웹페이지에서 직접 행동해야만 원하는 정보를 얻을 수 있습니다.
다시 공공자전거 이용량을 조사하는 상황을 생각해보겠습니다.
에이전트가 어느 도시의 공식 통계 사이트를 찾았다고 해보겠습니다. 사이트에는 이용 현황을 조회할 수 있다는 설명이 있지만, 실제 수치는 연도와 지역을 선택하고 '조회' 버튼을 눌러야 나타납니다.
다른 연도의 데이터를 확인하려면 선택을 바꾸고 다시 조회해야 할 수도 있습니다. 통계 항목에 대한 설명은 별도의 안내 페이지에 있을 수도 있습니다.
이런 상황에서는 웹페이지의 텍스트를 읽는 것만으로 충분하지 않습니다. 에이전트는 필요한 정보가 어디에 있는지 찾는 동시에, 그 정보를 얻기 위해 어떤 행동을 해야 하는지도 알아야 합니다.
웹에서의 정보 탐색과 행동은 서로 분리된 작업이 아니라 연결된 과정인 것입니다.
그런데 기존 웹 접근 방식들은 이 두 가지 기능을 서로 다른 형태로 제공해 왔습니다.
검색 API를 활용하면 여러 웹페이지에서 관련 정보를 빠르게 찾고 텍스트를 수집할 수 있습니다. 하지만 텍스트를 추출하는 과정에서 버튼, 입력창, 선택 메뉴와 같은 웹페이지의 조작 구조가 사라질 수 있습니다. 관련 페이지를 찾더라도 그 안에서 필요한 행동을 수행하기 어려운 것입니다.
반면 브라우저 기반 에이전트는 웹페이지를 직접 관찰하고 조작할 수 있습니다. 그러나 넓은 범위의 정보를 탐색할 때는 페이지마다 많은 요소와 구조를 확인해야 하므로, 실제로 필요한 정보보다 훨씬 많은 내용이 컨텍스트에 포함될 수 있습니다.
최근에는 웹페이지를 파일처럼 다루면서 셸 명령으로 필요한 부분을 선택적으로 읽는 접근도 등장했습니다. 다만 이러한 방식에서도 텍스트로 발견한 정보와 실제 웹페이지에서 실행할 수 있는 행동을 연결하는 것은 쉽지 않습니다.
Web$hell은 이러한 문제를 해결하기 위해 웹 검색과 웹 네비게이션을 하나의 인터페이스에서 지원하는 접근입니다.
핵심 아이디어는 웹페이지에 존재하는 정보와 실행 가능한 행동을 공통된 형태의 객체로 표현하고, 이들 사이의 관계를 유지하는 것입니다.
Web$hell은 이를 위해 세 가지 구성 요소를 사용합니다. WebContract는 웹페이지를 표현하고 접근하기 위한 공통 규칙을 정의하고, WebCompiler는 실제 웹페이지를 정보 객체와 행동 객체로 변환합니다. WebCache는 변환된 페이지와 상태를 저장해 이후에도 필요한 부분에 다시 접근할 수 있도록 합니다.
이때 각 객체에는 해당 요소를 이해하는 데 필요한 주변 맥락과 관련 객체에 대한 참조가 포함됩니다.
앞선 통계 사이트를 예로 들면, '조회 연도'라는 설명과 연도를 선택하는 메뉴가 서로 연결되어 있어야 합니다. 에이전트가 해당 설명을 읽다가 연도를 변경해야 한다고 판단했다면, 관련 선택 메뉴를 찾아 조작할 수 있어야 하기 때문입니다.
Web$hell에서는 이러한 관계를 유지하면서 에이전트가 필요한 정보 객체를 읽거나 연결된 행동 객체를 실행할 수 있도록 합니다.
행동을 수행한 뒤 달라진 페이지 상태도 탐색에 반영됩니다. 또한 이미 확보한 페이지와 상태를 다시 확인할 수 있으므로, 에이전트는 이전에 읽었던 정보로 돌아가거나 새로운 상태와 비교하며 조사를 이어갈 수 있습니다.
이러한 구조에서는 검색으로 발견한 정보가 다음 행동의 근거가 되고, 행동을 통해 얻은 정보가 다시 탐색의 단서가 됩니다.
예를 들어 에이전트는 통계 사이트를 찾아 조회 방법을 확인하고, 필요한 연도를 선택해 수치를 읽을 수 있습니다. 이후 다른 연도를 조회하거나, 발견한 수치의 집계 기준을 확인하기 위해 다른 페이지를 탐색할 수도 있습니다.
이처럼 Web$hell은 정적인 문서 검색을 넘어, 정보를 읽고 행동하며 다시 정보를 탐색하는 과정을 하나의 인터페이스로 연결합니다.
이러한 능력은 딥리서치뿐 아니라 웹 네비게이션에서도 중요합니다. 에이전트가 특정 자료를 다운로드하거나 웹사이트에서 일련의 작업을 완료해야 할 때도, 먼저 필요한 정보와 조작할 요소를 찾는 과정이 선행되기 때문입니다.
결국 웹 환경에서 검색은 단순히 관련 페이지를 발견하는 일에 그치지 않습니다. 필요한 행동을 찾아 실행하고, 그 결과를 확인하면서 목표에 도달하기 위한 탐색으로 확장됩니다.
검색 환경 자체가 스스로 발전할 수 있다면
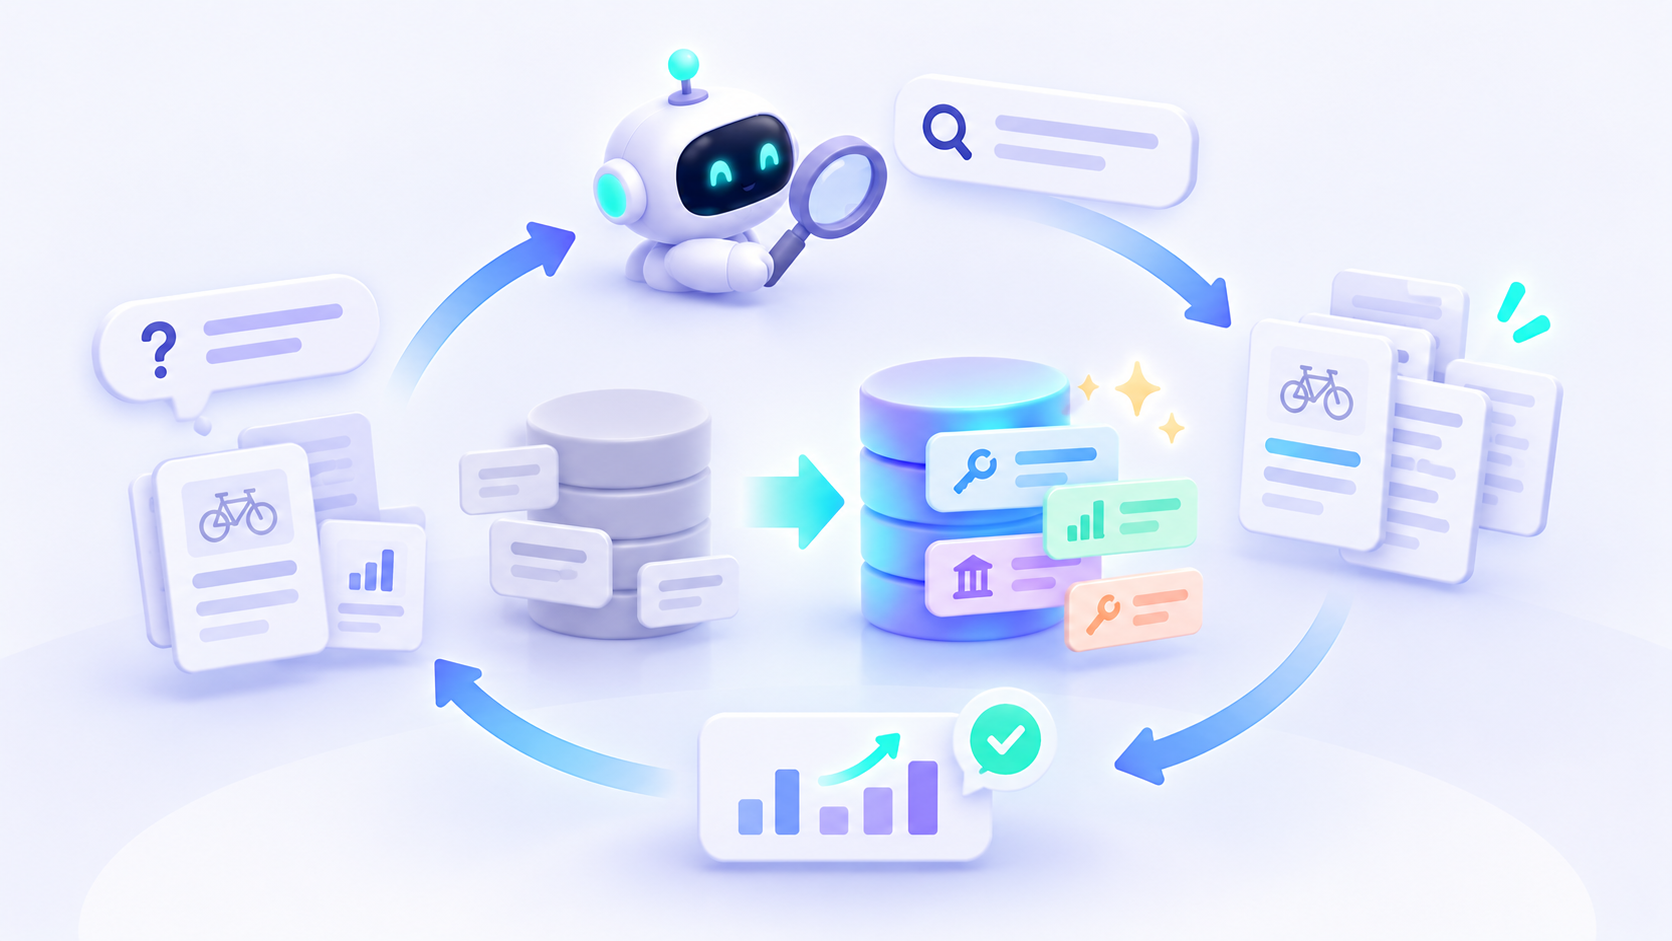
지금까지 살펴본 연구들은 에이전트가 외부 정보를 어떻게 탐색하고 활용할 수 있는지에 주목했습니다.
DCI는 원문을 직접 탐색할 수 있게 하고, IndexAct는 검색 후보를 유지하고 조작할 수 있도록 합니다. Web$hell은 이러한 정보 탐색을 웹페이지에서의 행동까지 확장합니다.
그런데 이처럼 다양한 탐색 방법이 제공되더라도, 한 가지 문제가 남습니다.
에이전트가 활용하는 검색 환경 자체가 필요한 정보를 제대로 찾을 수 있도록 구성되어 있는가 하는 점입니다.
예를 들어 공공자전거 관련 보고서에 '대여소 재배치'나 '운영 체계 개편'에 관한 설명이 있다고 해보겠습니다. 이러한 내용은 이용량 변화의 원인을 분석하는 데 중요한 단서가 될 수 있습니다.
하지만 인덱스가 해당 문서를 단순한 운영 실적 보고서로만 표현하고 있다면, '공공자전거 정책 변화'와 관련된 정보를 찾는 과정에서 그 문서가 쉽게 발견되지 않을 수 있습니다.
이는 에이전트가 검색을 잘못 수행해서가 아니라, 검색에 사용되는 인덱스가 필요한 정보를 충분히 표현하지 못했기 때문에 발생할 수 있는 문제입니다.
이런 문제를 해결하려면 검색 인덱스가 문서의 어떤 정보를 검색 가능한 형태로 표현할지 조정해야 합니다. 하지만 기존에는 검색 실패를 분석하고 인덱스를 수정하는 과정에 많은 사람의 개입과 비용이 필요했습니다.
Self-Index는 이러한 인덱스 최적화 과정을 자동화하는 접근입니다.
Self-Index는 검색 과정에서 관측된 결과를 바탕으로 인덱스의 문제를 진단하고, 개선이 필요한 문서의 검색 키(Index Key)를 선택적으로 수정합니다.
수정된 키는 원문에 충실한지, 해당 문서의 고유한 정보를 담고 있는지, 다른 문서와 충분히 구분되는지를 검증한 뒤 인덱스에 반영됩니다. 이 과정에서 원본 문서를 수정하는 것이 아니라, 해당 문서를 검색하기 위한 표현을 개선합니다.
또한 실제로 들어온 질의만 활용하는 것이 아니라, Query Simulator를 통해 아직 관측하지 못한 정보 수요를 탐색하고 이를 인덱스 개선에 활용합니다.
이를 통해 인덱스는 처음 구축된 상태에 고정되지 않고, 변화하는 검색 수요에 맞춰 점진적으로 개선될 수 있습니다.
앞선 연구들이 에이전트에게 어떤 탐색 동작을 제공할 것인가에 초점을 맞췄다면, Self-Index는 에이전트가 활용하는 검색 기반을 어떻게 지속적으로 개선할 것인가라는 문제를 다룹니다.
두 방향은 서로 다른 문제이지만, 에이전트 중심의 검색 환경을 설계한다는 관점에서 연결됩니다.
에이전트에게 다양한 탐색 동작을 제공하는 것뿐 아니라, 그 동작이 활용하는 검색 인덱스도 실제 정보 수요에 맞춰 개선할 수 있기 때문입니다.
더 나아가 에이전트의 작업과 탐색 패턴에 따라 인덱스뿐 아니라 제공하는 검색 도구와 탐색 방식까지 조정할 수 있다면 어떨까요?
이는 아직 더 탐구해야 할 방향이지만, 검색 환경이 에이전트에게 주어진 고정된 도구를 넘어 에이전트의 정보 수요에 맞춰 함께 발전하는 시스템으로 확장될 가능성을 보여줍니다.
좋은 검색 에이전트는 좋은 모델만으로 만들어지지 않는다
AI 에이전트의 등장으로 검색의 역할이 달라지고 있습니다.
과거에는 사용자의 질문과 관련된 정보를 잘 찾아 전달하는 것이 검색 시스템의 중요한 목표였습니다. 그러나 이제는 에이전트가 스스로 정보를 탐색하고, 근거를 검증하며, 필요에 따라 탐색 방향을 수정하는 과정까지 지원해야 합니다.
이러한 변화 속에서 검색 인터페이스가 담당하는 역할도 넓어지고 있습니다.
에이전트가 원문을 직접 읽을 수 있는지, 여러 검색 후보를 유지하고 조작할 수 있는지, 웹페이지에서 필요한 행동으로 이어갈 수 있는지에 따라 같은 정보를 활용하는 방식도 달라집니다. 여기에 정보 수요에 맞춰 검색 인덱스까지 개선할 수 있다면, 탐색 환경 자체가 지속적으로 발전할 수도 있습니다.
이 관점에서는 검색 실패를 바라보는 방식도 달라집니다.
에이전트가 중요한 근거를 놓쳤다면 모델의 추론 능력만이 원인은 아닐 수 있습니다. 필요한 정보가 검색 가능한 형태로 표현되지 않았거나, 관련 문서를 충분히 탐색할 수 없었거나, 검색 과정에서 얻은 정보를 다음 탐색에 활용할 수 없었기 때문일 수도 있습니다.
따라서 에이전트의 성능을 높이기 위해서는 모델 자체의 발전뿐 아니라, 모델이 외부 정보와 상호작용하는 방식도 함께 고민해야 합니다.
앞으로 딥리서치와 웹 네비게이션처럼 여러 단계의 탐색과 판단이 필요한 작업이 더욱 복잡해질수록, 이러한 중요성은 커질 것입니다.
AI가 검색하는 시대에는 모델이 얼마나 잘 생각하는지만큼, 그 생각을 실제 탐색으로 옮길 수 있는 환경을 어떻게 만드는지도 중요해질 것입니다.
References
1. Zhuofeng Li et al. Beyond Semantic Similarity: Rethinking Retrieval for Agentic Search via Direct Corpus Interaction. 2026.
2. Deogyong Kim et al. From Delivery to Stateful Exploration: Rethinking the Index for Agentic Search. 2026.
3. Sunghwan Kim et al. Web$hell: A Unified Interface for Agentic Web Access. 2026.
4. Sangam Lee et al. Self-Evolving Search Index. 2026.