AI Insight
글을 쓰지 않고 선택하는 AI, 왜 필요할까? Jev와 LLM의 역할 분담

문장으로 답하지 않는 Jev는 무엇을 할까?
우리는 AI에게 질문하면 문장으로 된 답변을 받는 일에 익숙합니다. 설명을 요청하면 설명을, 글을 부탁하면 글을 만들어줍니다. 그런데 AI의 답이 항상 문장이어야 할까요?
TypeSafe AI가 공개한 Jev는 반복되는 선택과 평가를 빠르게 처리하도록 설계된 판단 모델입니다. 주어진 상황과 질문을 바탕으로 긴 설명문 대신 선택·점수·확률을 반환합니다. Jev 공식 소개
Jev가 반환하는 판단 결과는 에이전트가 읽을 자료를 고르고, 사용할 모델을 정하거나, 추가 검토가 필요한지 결정하는 데 활용될 수 있습니다. 이 글에서는 검색 연구와 실제 활용 사례를 통해,이러한 판단을 LLM과 연결하는 방식이 에이전트의 작업 과정과 최종 결과에 어떤 영향을 미치는지 살펴봅니다.
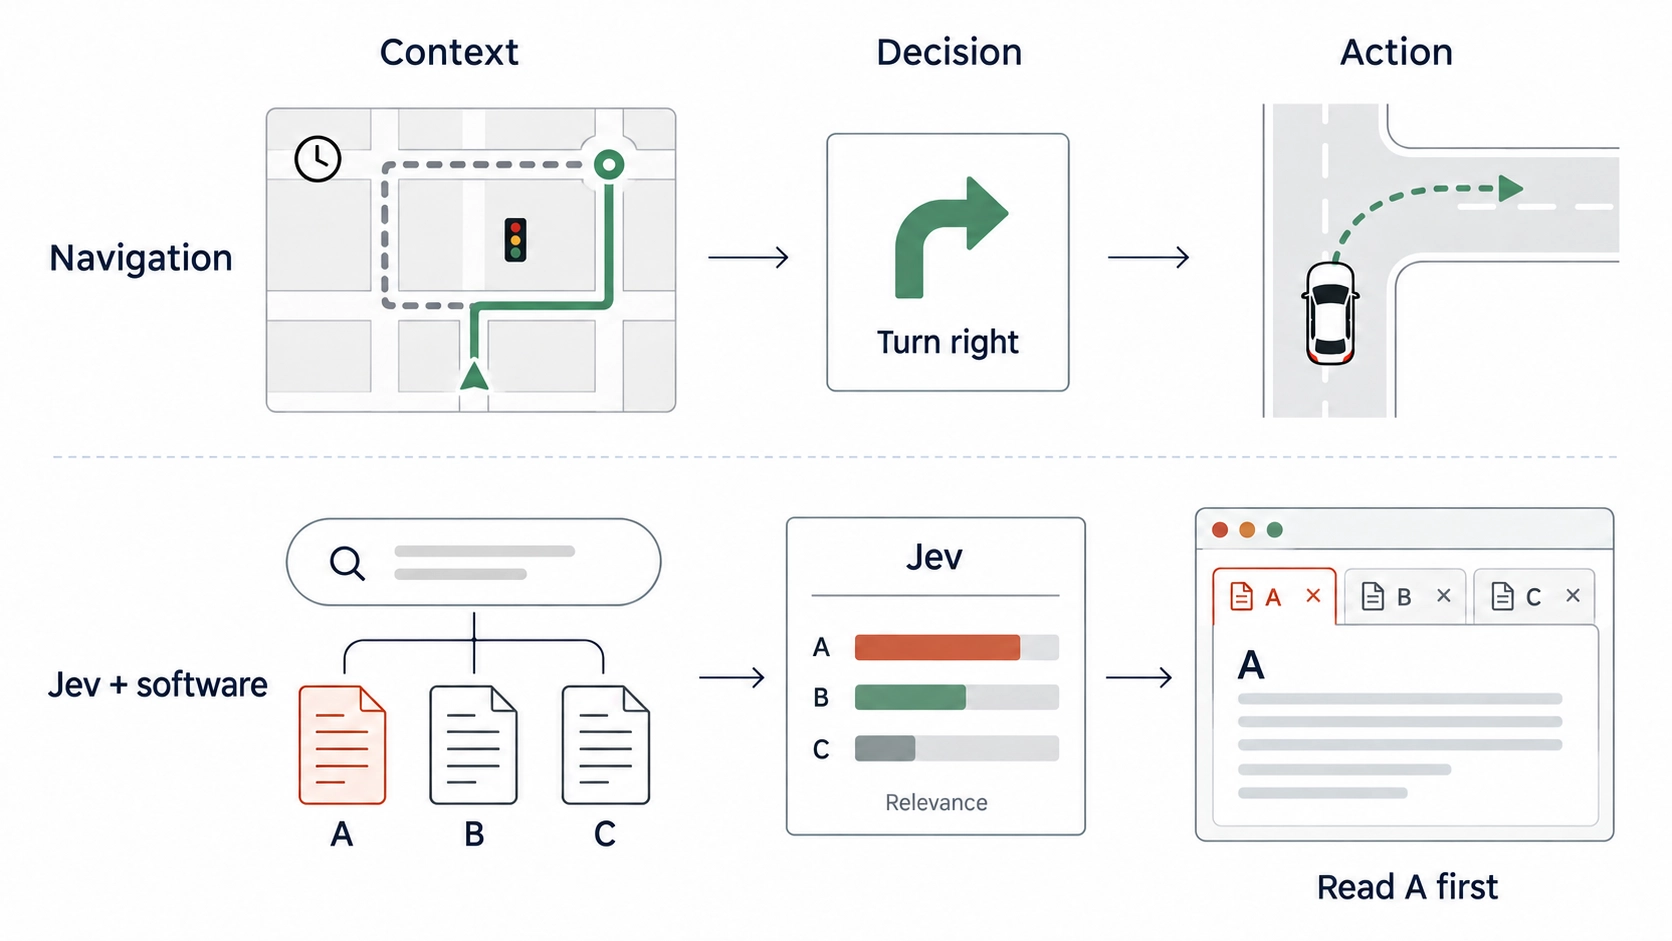
먼저, 짧은 판단 결과가 어떻게 다음 행동으로 이어지는지 내비게이션을 통해 생각해보겠습니다.
목적지까지 가는 길을 정하려면 거리와 교통 상황, 예상 소요 시간을 비교해야 합니다. 하지만 갈림길에 도착한 운전자에게 당장 필요한 것은 “다음 교차로에서 우회전하세요”라는 안내입니다. 운전자는 경로를 비교한 과정을 모두 전달받지 않아도, 짧은 안내를 바탕으로 다음 행동을 정할 수 있습니다.
프로그램에도 이런 순간이 있습니다. 검색한 문서를 읽을지, 자료를 더 찾을지, 다른 모델에 검토를 맡길지 정할 때입니다. 내비게이션의 안내를 받아 운전자가 움직이듯, 프로그램은 Jev의 판단 결과를 받아 다음 작업을 수행합니다.
Jev에는 무엇을 주고 어떤 결과를 받을까?
앞에서 본 문서 선택 과정을 조금 더 구체적으로 살펴보겠습니다. 에이전트가 다음 요청을 수행하고 있다고 해보겠습니다.
“Jev를 우리 서비스에 활용할 수 있을지 조사해줘.”
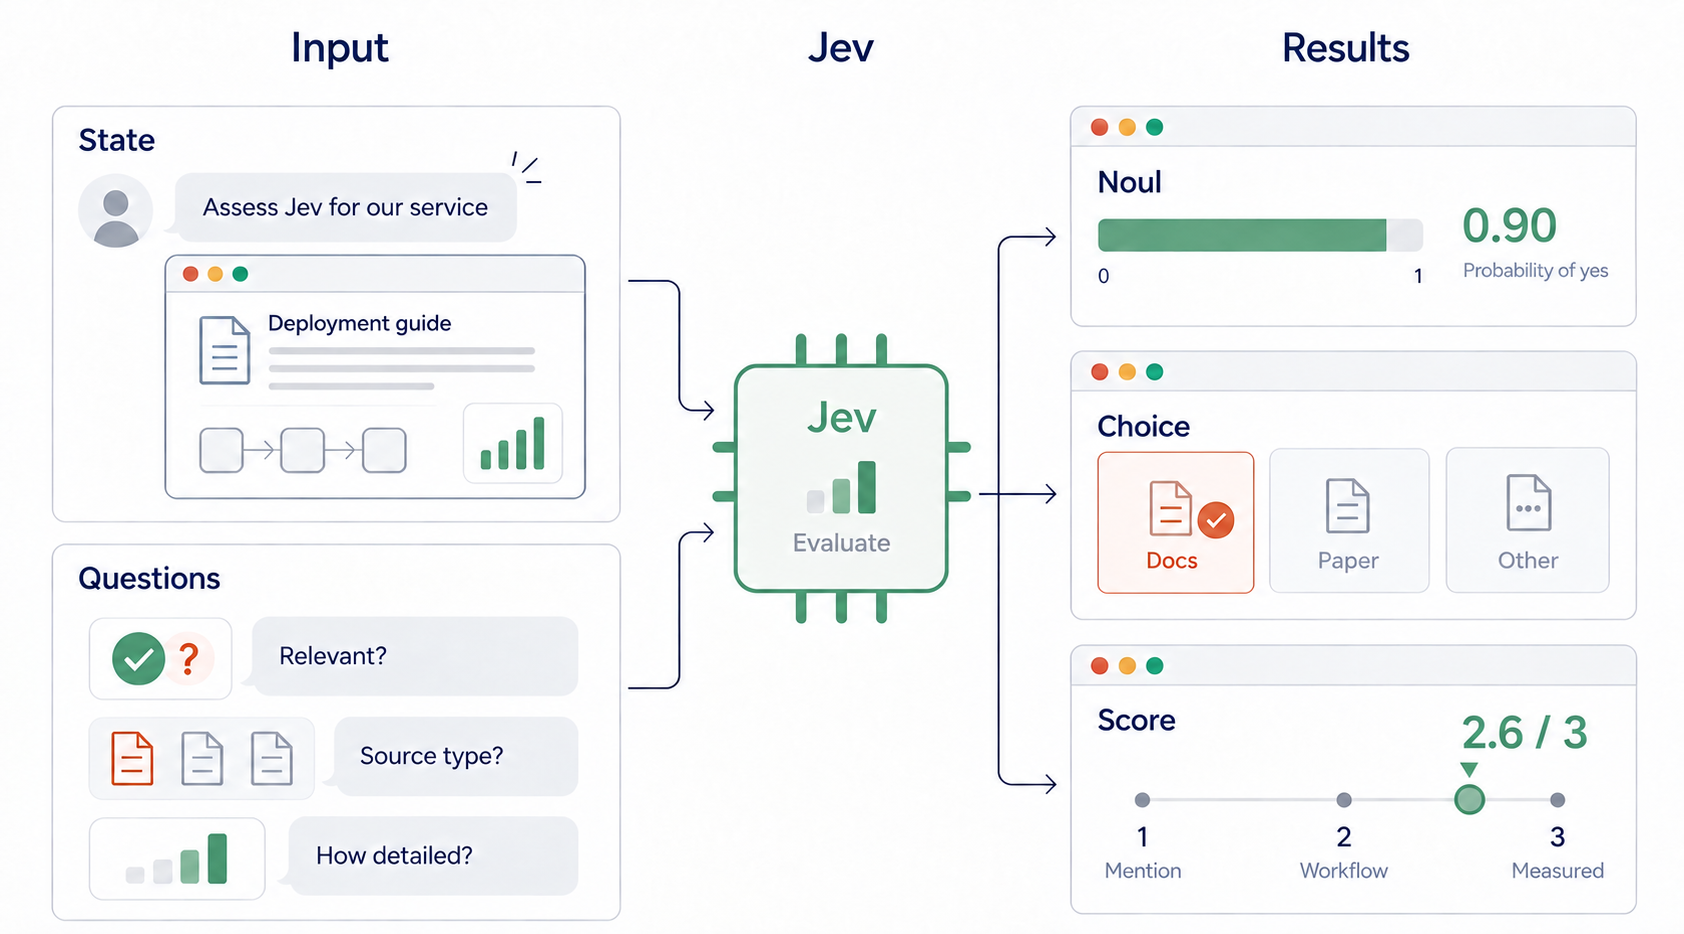
검색 결과 중 어떤 자료를 읽을지 고르려면, Jev에 판단할 정보와 질문을 제공해야 합니다. 입력은 크게 두 부분으로 나뉩니다.
- 상태(state): 판단에 필요한 정보입니다. 여기서는 사용자의 조사 요청과 검색한 문서의 제목·요약을 넣습니다.
- 질문(questions): 무엇을 판단할지 지정합니다. 질문과 함께 원하는 답변 유형, 선택지나 평가 기준을 제공합니다.
같은 문서에 대해서도 필요한 결과에 따라 질문을 달리할 수 있습니다.
- Noul — “이 문서가 조사 주제와 관련 있는가?” ‘그렇다’고 판단하는 확률을 0~1로 받습니다.
- Choice — “어떤 종류의 자료인가?” ‘공식 문서·연구 논문·활용 후기·기타’처럼 미리 정한 선택지 중 하나와 선택지별 확률을 받습니다.
- Score — “이 자료는 활용 경험을 얼마나 구체적으로 설명하는가?” ‘언급 없음·사용 과정 설명·측정 결과까지 제시’처럼 수준별 기준을 정하고, 그에 따른 점수와 각 수준의 확률을 받습니다.
각 유형의 자세한 입력과 반환값은 공식 문서에서 확인할 수 있습니다.
판단 결과는 어떻게 실제 행동으로 이어질까?
이렇게 받은 결과를 조합하면 자료를 검토하는 순서를 정할 수 있습니다. 프로그램은 관련성 확률로 먼저 읽을 문서를 고르고, 자료 유형에 따라 분류하며, 활용 경험을 구체적으로 설명한 자료를 우선 검토하도록 구성할 수 있습니다.
Jev가 판단 결과를 제공하면, 프로그램은 정해진 처리 기준에 따라 그 결과를 행동으로 연결합니다. 문서마다 긴 평가문을 작성하지 않아도 다음 작업을 진행할 수 있는 이유입니다.
기존 LLM도 이런 선택과 평가를 수행할 수 있습니다. 그렇다면 왜 이를 별도의 판단 모델에 맡기려는 걸까요?
에이전트의 모든 판단에 깊은 추론이 필요할까?
기존 LLM에도 문서의 관련성을 평가하거나, 정해진 선택지 중 하나를 고르도록 요청할 수 있습니다. 구조화된 출력을 사용하면 프로그램이 처리할 형태로 결과를 받는 것도 가능합니다.
그렇다면 판단 모델의 차이는 어디에 있을까요? 먼저 결과를 전달하는 형식과, 그 결과를 계산하는 방식을 구분할 필요가 있습니다.
LLM에서 JSON으로 받는 것과 무엇이 다를까?
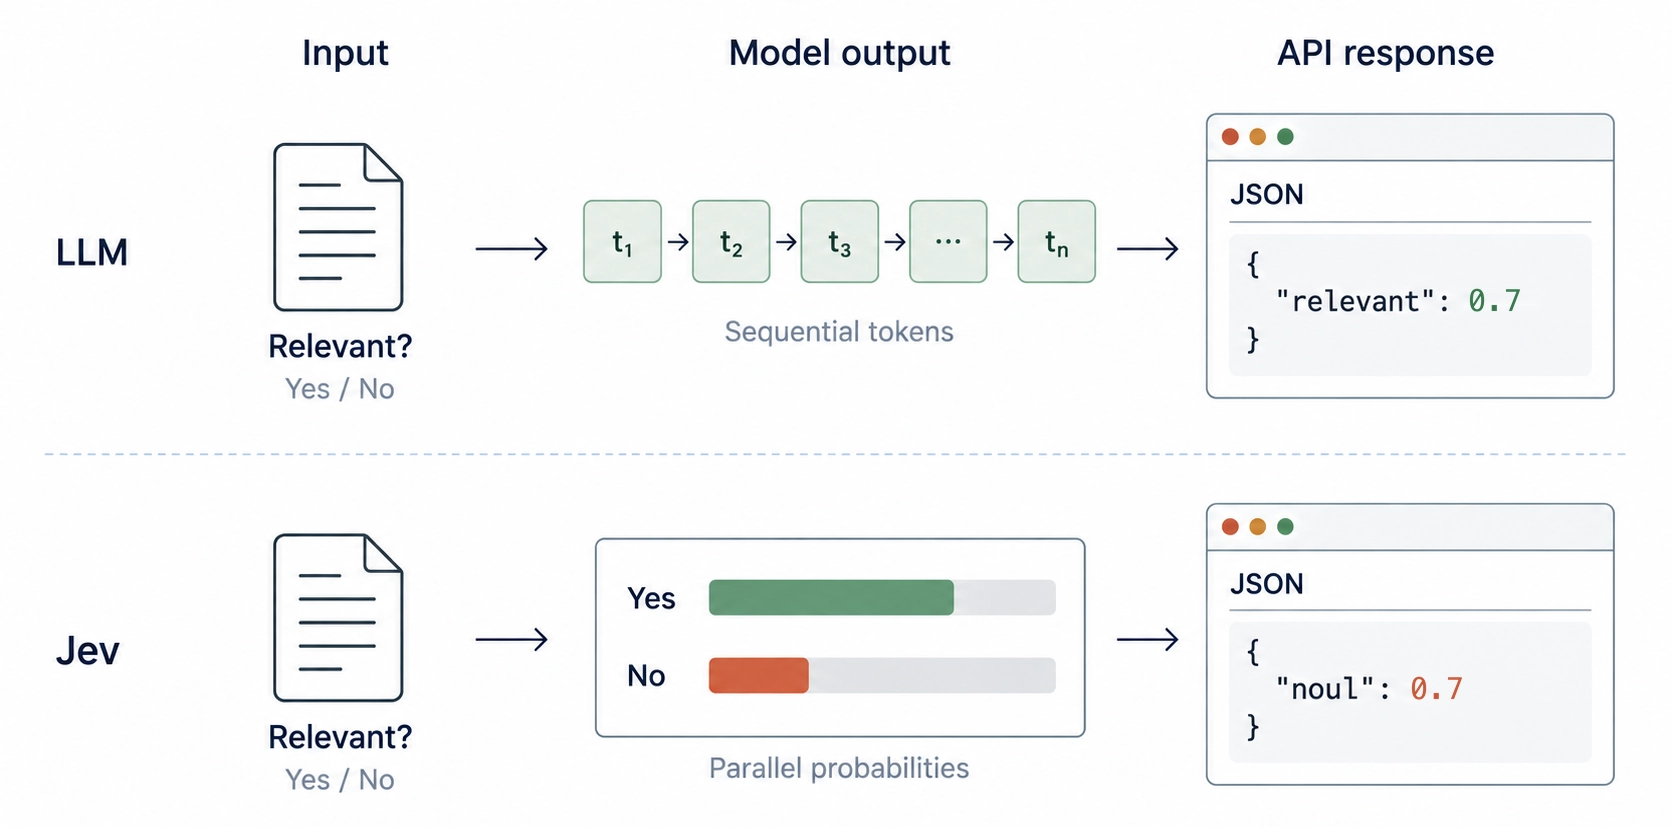
LLM에 문서가 조사 주제와 관련 있을 확률을 0~1 사이의 숫자로 반환하도록 요청하면, 다음과 같은 응답을 받을 수 있습니다.
{"relevant": 0.7}응답은 짧지만, 일반적인 생성형 LLM은 이 결과도 토큰을 순차적으로 생성해 만듭니다. 반면 TypeSafe는 Jev가 자유로운 문자열을 생성하는 대신, 정해진 선택지와 평가 기준에 대한 확률을 병렬로 반환하도록 설계됐다고 설명합니다. Jev 공식 소개
Jev의 응답을 JSON으로 전달받더라도 마찬가지입니다. JSON은 결과를 담는 형식일 뿐, 모델이 내부에서 그 문자열을 차례로 생성했다는 뜻은 아닙니다. 겉으로 비슷한 결과를 받아도, 그 결과를 얻는 계산 과정은 다를 수 있습니다.
이 차이는 판단이 반복될 때 중요해집니다. 앞의 조사 요청을 수행하려면 검색 결과마다 읽을 가치가 있는지 평가하고, 자료를 모은 뒤에는 답변할 근거가 충분한지 확인해야 합니다. 문서와 검색 단계가 늘어날수록 이러한 판단에 드는 시간과 비용도 쌓입니다.
그렇다면 읽을 문서를 고르는 일과, 여러 자료를 종합해 도입 가능성을 분석하는 일을 모두 같은 모델에 맡겨야 할까요? 반복되는 선택은 판단 모델이 처리하고, 자료를 비교하고 해석하는 일은 LLM이 맡도록 나눌 수 있습니다.
어떤 작업을 판단 모델에 맡길 수 있을까?
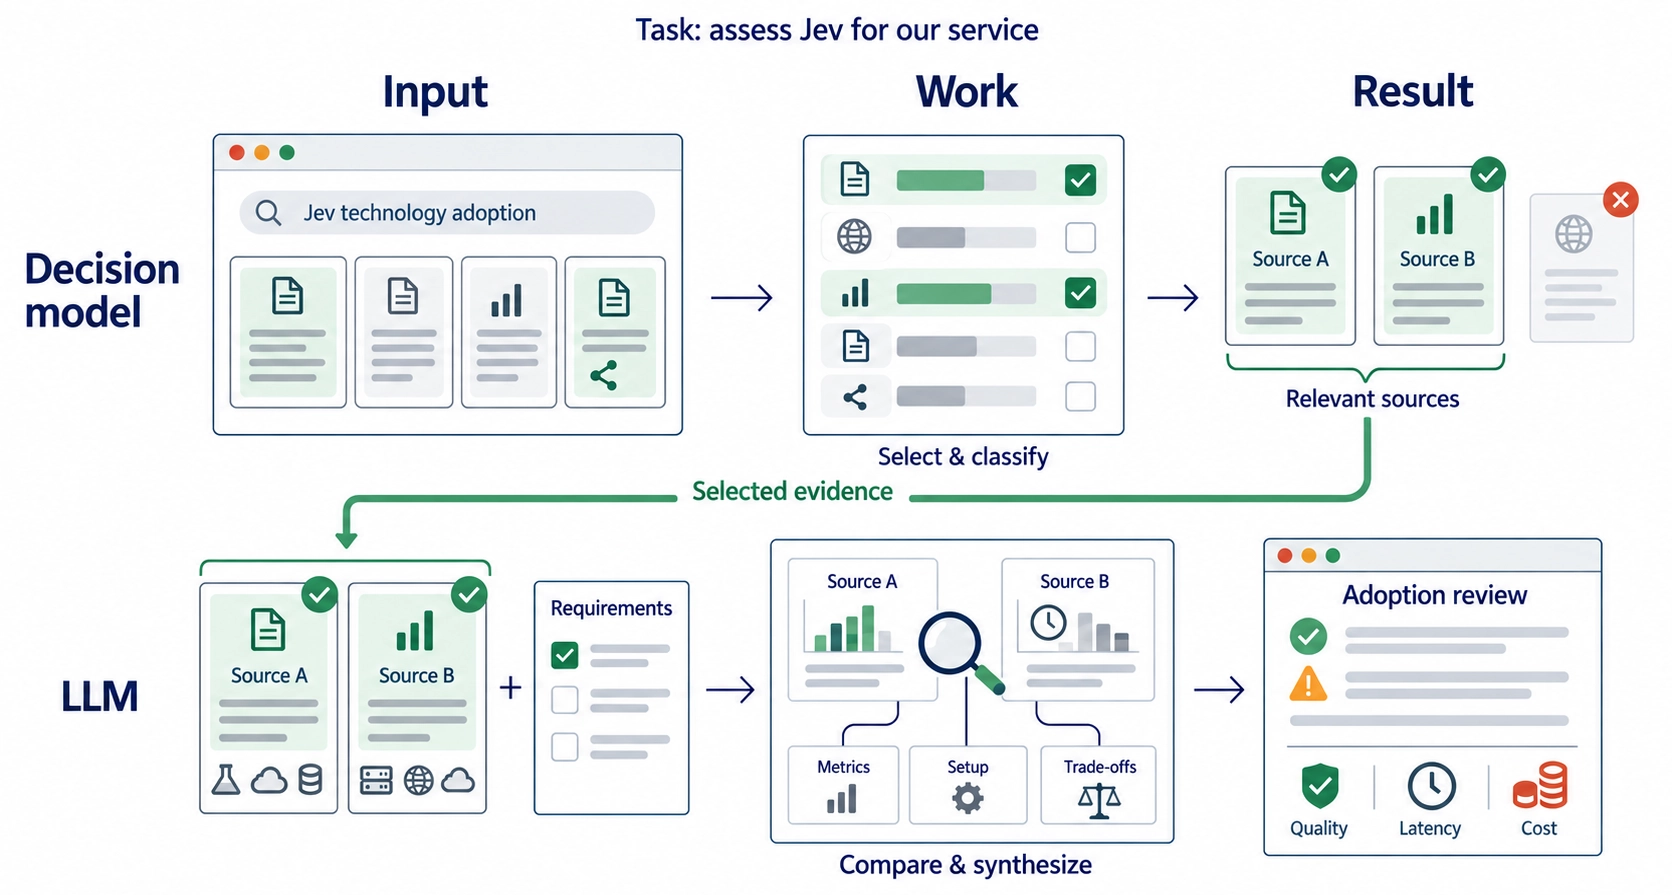
“Jev를 우리 서비스에 활용할 수 있을지 조사해줘”라는 요청을 다시 살펴보겠습니다.
어떤 문서는 제목과 요약만으로도 조사와 관련 있는지 비교적 쉽게 알 수 있습니다. 반면 여러 논문의 성능 수치를 비교해 도입 가능성을 판단하는 일은 더 많은 검토가 필요합니다.
한 논문은 문서 분류 정확도를, 다른 논문은 최종 답변의 정확도를 측정했을 수 있습니다. 속도 역시 입력 길이와 하드웨어, 추론 설정에 따라 달라집니다. 따라서 무엇을 어떤 조건에서 측정했는지 해석하고, 그 결과가 우리 서비스의 품질·응답 시간·비용 요구에 맞는지 종합해야 합니다.
이러한 작업의 차이를 고려해 다음처럼 역할을 나눌 수 있습니다.
- 판단 모델: 문서의 관련성이나 자료 유형처럼 반복되는 선택·평가를 처리합니다.
- LLM: 조사 계획을 세우고, 서로 다른 자료를 해석·종합해 답변을 작성합니다.
역할을 나누기만 하면 될까?
다만 답이 짧다고 판단까지 항상 간단한 것은 아닙니다. 관련 문서를 잘못 제외하면, 뒤에서 답변을 작성하는 LLM이 필요한 근거를 놓칠 수 있습니다. 앞단의 판단이 뒤에서 사용할 정보를 바꾸기 때문입니다.
따라서 역할을 나눈 효과는 개별 판단을 얼마나 빠르게 처리하는지뿐 아니라, 그 판단을 거쳐 완성한 답변의 품질과 전체 작업 시간에서 확인해야 합니다.
실제 검색 에이전트에서는 이러한 역할 분담을 어떻게 구현하고, 어떤 결과를 얻었을까요? SearchJev를 통해 살펴보겠습니다.
판단을 따로 맡기면 검색 과정은 어떻게 달라질까?
SearchJev는 앞에서 살펴본 역할 분담을 검색 에이전트에 적용한 연구입니다. Huawei와 Leiden University 연구진은 TypeSafe의 Jev에서 영감을 받아, Qwen3.5를 검색 판단에 특화한 별도의 모델인 SearchJev를 개발했습니다. 이 모델은 검색 중 반복되는 판단을 담당하고, LLM은 검색 계획·검색어 생성·최종 답변 작성을 맡습니다. 연구진은 이러한 역할 분담이 전체 검색 시간과 최종 답변의 정확도에 어떤 영향을 미치는지 평가했습니다. SearchJev 논문
앞에서 살펴본 “Jev를 우리 서비스에 활용할 수 있을지 조사해줘”라는 요청을 이어가 보겠습니다. 에이전트가 관련 문서를 찾았다고 해서 바로 답할 수 있는 것은 아닙니다. 기능 소개는 확보했지만, 실제 서비스에서 어느 정도의 응답 시간과 비용이 드는지, 어떤 제약이 있는지 확인할 자료는 아직 없을 수 있습니다.
이때 에이전트는 어떤 자료를 읽고, 무엇을 더 찾아야 할지 정해야 합니다.
검색 과정에서 어떤 판단을 따로 맡길까?
먼저 검색 결과에서 읽을 자료를 골라야 합니다. 우리 예시라면 Jev의 공식 문서나 도입 후기는 살펴볼 가치가 있지만, 이름만 비슷한 다른 서비스의 소개는 제외할 수 있습니다. 이는 문서 관련성 판단입니다.
자료를 읽은 다음에는 다른 질문이 생깁니다. “이제 사용자의 요청에 답할 수 있을까?” 모델이 제공하는 기능만 확인했다면, 실제 서비스에 도입할 수 있을지 결론을 내리기에는 부족할 수 있습니다. 이는 근거 충분성 판단입니다.
두 판단은 검색의 서로 다른 부분을 바꿉니다.
- 관련성 판단: 어떤 문서를 LLM에 전달할지 정하는 데 사용합니다.
- 충분성 판단: 자료를 더 찾을지, 확보한 근거로 답변하도록 할지 정하는 데 사용합니다.
SearchJev는 현재 검색 상태와 판단할 질문, 허용된 선택지를 입력받아 결과를 반환합니다. 프로그램은 이 결과를 문서 선별과 검색 진행에 연결합니다. 어떤 자료를 남기고 언제 검색을 마칠지에 따라, 답변을 작성하는 LLM이 받는 정보도 달라지는 것입니다.
검색 판단을 맡을 모델은 어떻게 만들고 연결했을까?
이러한 역할을 맡기려면, 검색 상태를 읽고 주어진 선택지를 평가할 모델이 필요합니다. 연구진은 Qwen3.5의 0.8B·4B 모델을 검색 판단에 맞게 추가 학습했습니다. 문서 관련성이나 근거 충분성처럼 여러 종류의 판단 데이터를 공통된 입력 형식으로 정리해 학습에 사용했습니다. 또한 판단의 불확실성을 반영하도록 확률 분포를 학습하고 보정해, 확신 수준에 따라 판단을 직접 처리하거나 LLM에 맡길 수 있도록 했습니다.
결과를 내는 방식도 판단에 맞췄습니다. 설명문이나 JSON을 순차적으로 생성하는 대신, 첫 출력 위치에서 각 선택지에 해당하는 점수를 읽어 확률로 변환합니다. 앞 절에서 설명한 ‘결과를 전달하는 형식’과 ‘결과를 계산하는 방식’의 차이를 구체적으로 구현한 사례입니다.
이 모델을 검색 에이전트에 연결하면 다음과 같이 역할을 나눌 수 있습니다.
- LLM이 조사 계획과 검색어를 만듭니다. 사용자 요청을 해결하려면 무엇을 알아야 하는지 정하고, 필요한 자료를 찾을 검색어를 작성합니다.
- SearchJev가 검색 결과와 확보한 근거를 평가합니다. 문서가 질문과 관련 있는지, 현재 근거로 답할 수 있는지 판단합니다. 판단에 대한 확신이 낮으면 LLM에 재검토를 맡깁니다.
- 프로그램이 판단 결과를 다음 행동으로 연결합니다. LLM에 전달할 문서를 추리고, 추가 검색을 진행하거나 답변 작성으로 넘어가도록 제어합니다.
- LLM이 자료를 종합해 최종 답변을 작성합니다. 확보한 근거를 해석하고 사용자의 질문에 맞는 설명을 만듭니다.
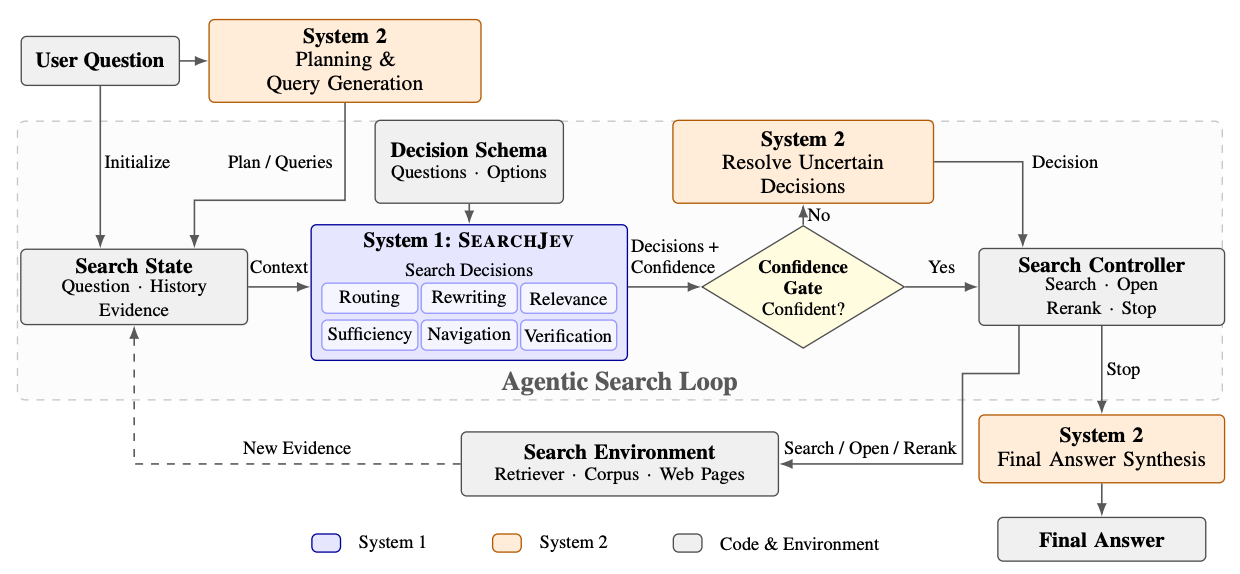
검색이 한 번으로 끝나지 않으면 자료를 찾고 평가하는 과정도 반복됩니다. 이처럼 판단을 나누어 맡기면, 실제로 시간을 줄이면서 답변의 품질도 유지할 수 있을까요?
같은 LLM을 사용해도 결과가 달라졌을까?
연구진은 BrowseComp-Plus의 질문 100개를 대상으로 전체 검색 과정을 비교했습니다. 검색 계획·검색어 생성·최종 답변 작성을 담당하는 모델은 Qwen3.5-27B, 검색기는 BM25로 고정했습니다. 같은 문서 집합을 검색하는 환경에서, LLM이 검색 중의 판단까지 수행하는 구성과 별도의 판단 모델을 사용하는 구성을 비교한 것입니다.
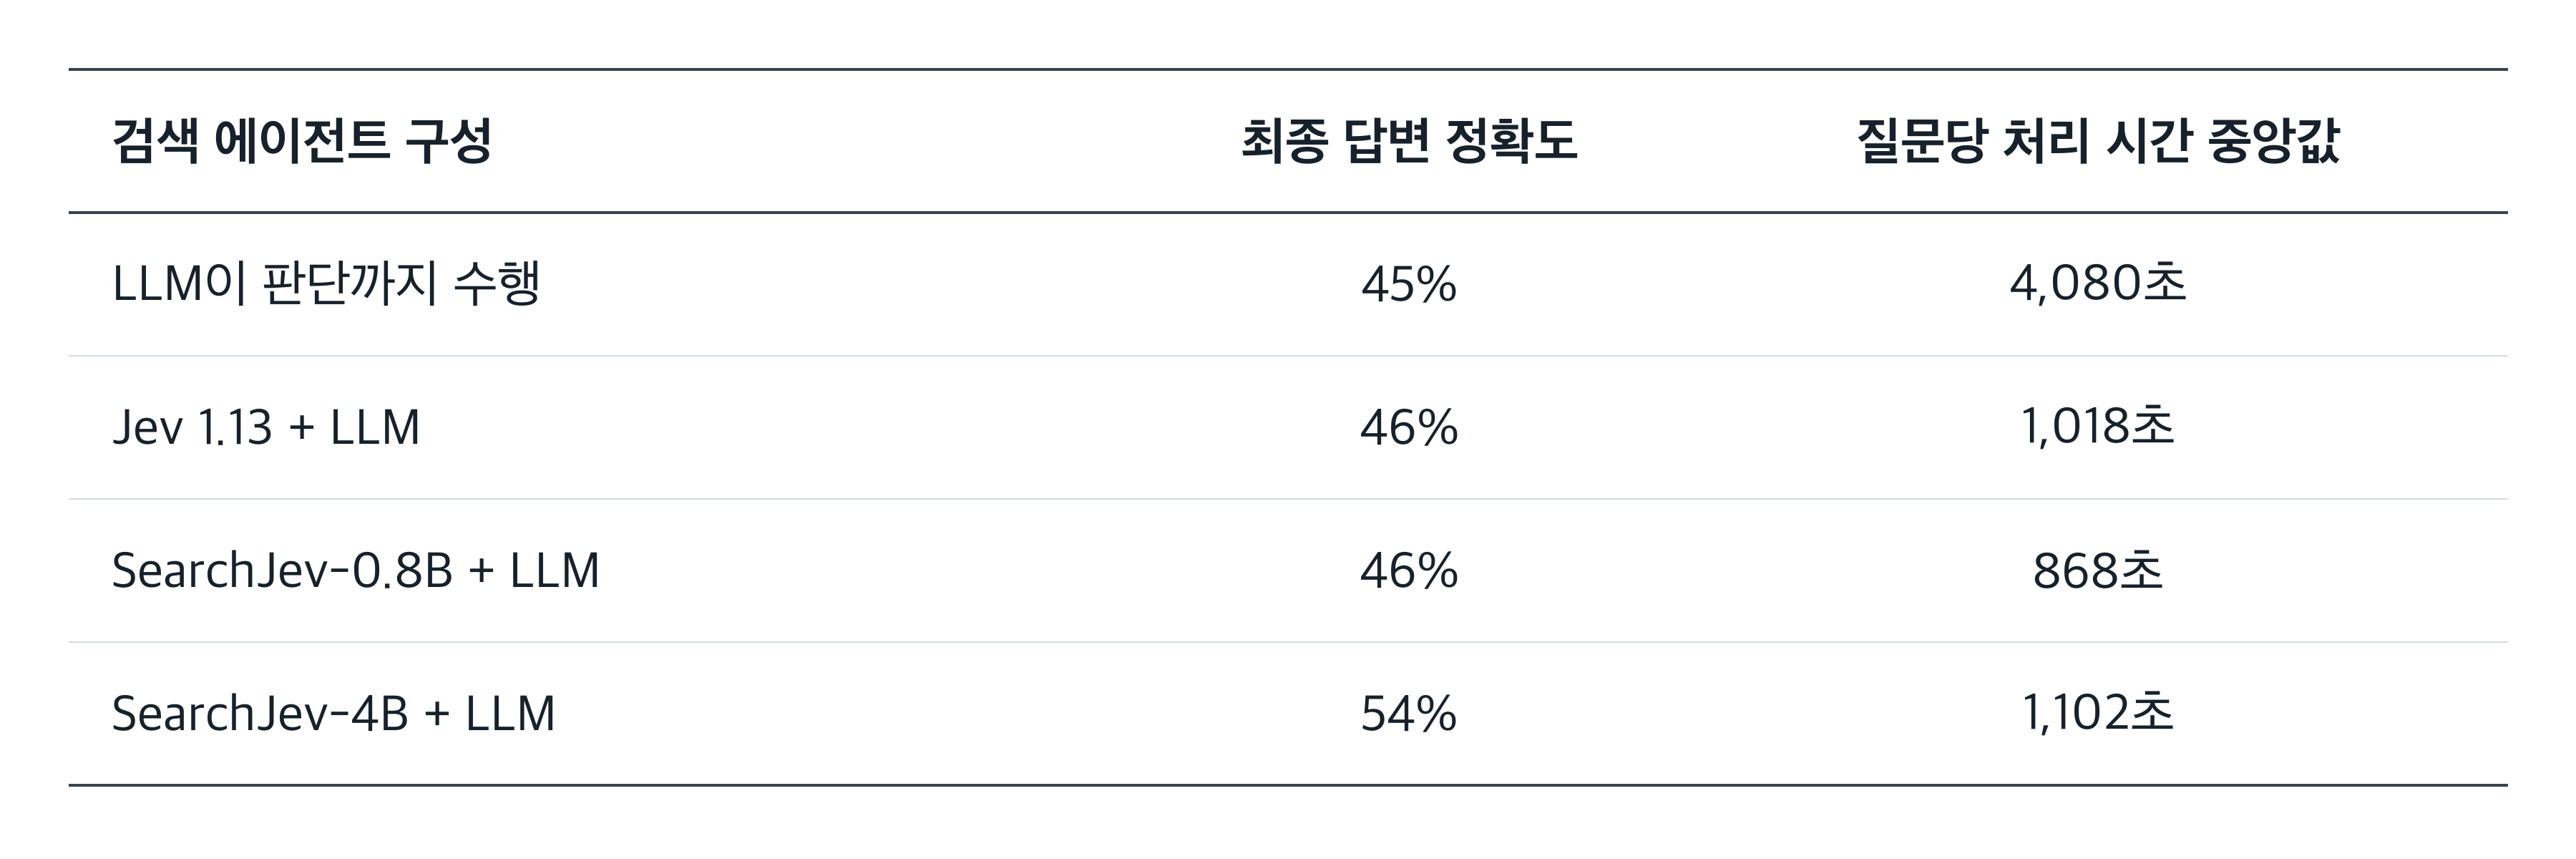
동일한 검색 환경에서 SearchJev-0.8B를 결합한 구성은 질문당 처리 시간 중앙값이 약 68분에서 14.5분으로 줄었고, 정확도는 45%에서 46%로 나타났습니다. SearchJev-4B 구성은 약 18.4분이 걸렸으며, 정확도는 54%였습니다.
SearchJev의 결과는 답변을 생성하는 LLM을 바꾸지 않더라도, 검색 중의 판단을 어떤 모델에 맡기느냐에 따라 전체 처리 시간과 최종 정확도가 달라질 수 있음을 보여줍니다. 다만 100개 질문을 대상으로 한 실험이므로, 다른 서비스에서도 같은 개선 폭을 기대할 수 있는지는 별도로 확인해야 합니다.
검색에서는 읽을 자료와 검색을 이어갈 시점을 정했습니다. 그렇다면 요청을 처리할 모델을 고르거나, 많은 대상 중 상세히 검토할 대상을 추리는 일에도 이러한 역할 분담을 활용할 수 있을까요?
실제 서비스와 구현 사례에서는 판단을 어디에 배치할까?
검색 밖에서도 프로그램은 어떤 모델을 호출할지, 무엇을 우선 검토할지, 지금 도구를 실행해도 될지 정해야 합니다. 실제 서비스와 공개된 구현 사례에서는 이러한 분기점에 판단 모델을 어떻게 배치하고 있을까요?
어떤 AI에게 물어볼지도 AI가 고를 수 있을까?
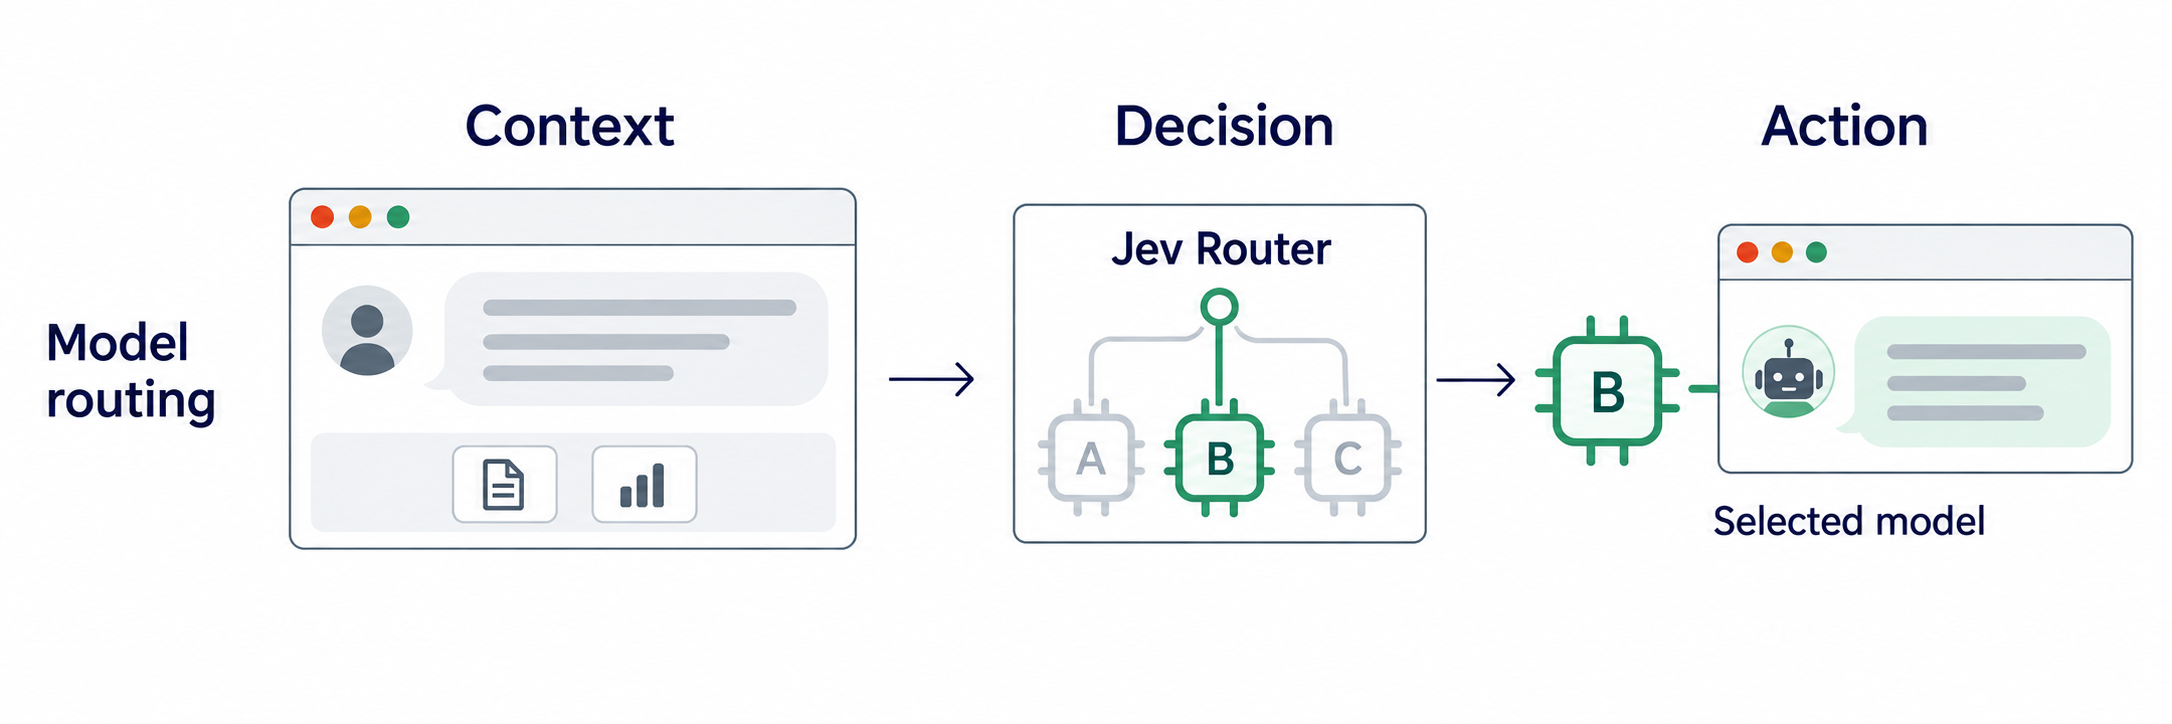
사용자가 질문을 보내면, 답변을 작성하기 전에 다른 AI가 먼저 요청을 살펴봅니다. 이 AI가 고르는 것은 답변을 맡길 모델입니다.
OpenRouter의 Jev Router가 이런 역할을 합니다. Jev가 요청의 종류와 난이도 등을 평가하면, 라우팅 정책이 예상 비용과 사용자의 설정을 함께 반영해 모델과 추론 수준을 선택합니다. 실제 답변은 선택된 모델이 작성합니다. Jev Router 공식 문서
SearchJev가 LLM에 전달할 정보를 선택했다면, Jev Router는 그 작업을 수행할 모델과 추론 설정을 선택합니다. 요청에 따라 다음 단계에 사용할 계산 자원을 달리 배분하는 것입니다.
후보가 6,000명이라면, 누구부터 자세히 검토할까?
검토할 대상이 수천 개라면, 어떤 대상에 상세한 분석을 집중할지도 정해야 합니다.
채용 매칭 서비스 Jack & Jill은 채용 포지션마다 약 6,000명의 후보를 초기 평가하고, 상위 2,000명을 별도의 모델로 상세히 검토합니다. 이후 추린 후보를 채용 담당자에게 보여줍니다. Jev는 이 중 기존 모델이 맡던 초기 평가 단계에 도입됐습니다. Jack & Jill 도입 사례
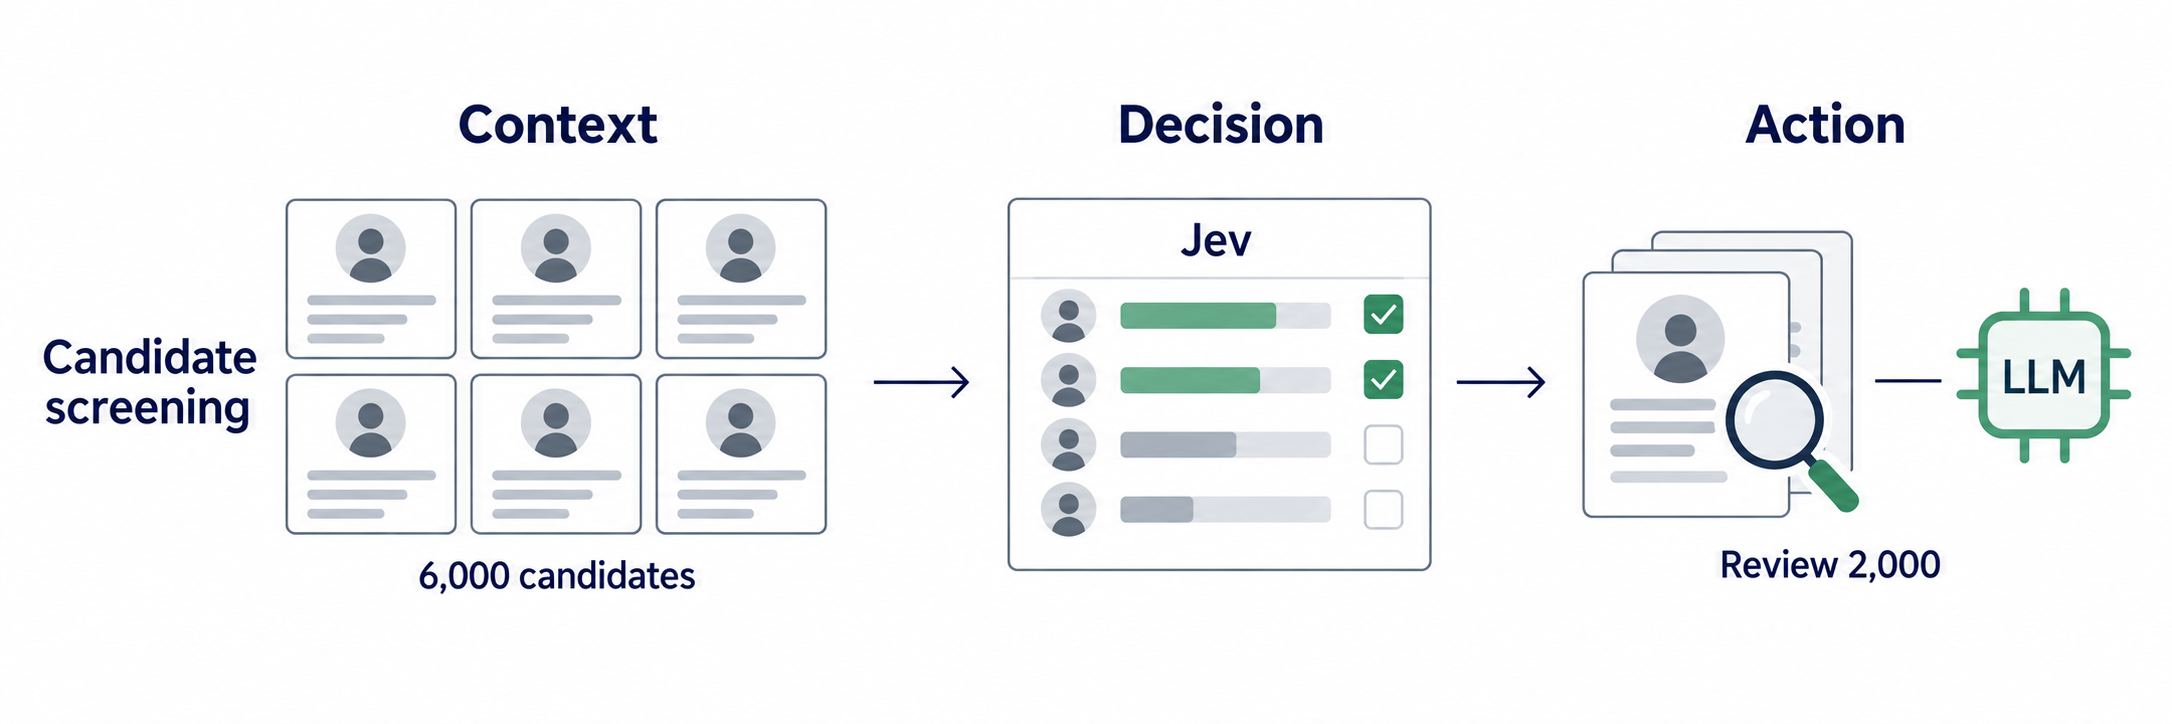
TypeSafe가 공개한 150개 채용 포지션 대상 비교에서는 초기 평가 단계의 비용이 약 88% 감소했고, 처리 시간 중앙값은 20.3초에서 10.3초로 줄었습니다. 채용 담당자가 이후 요청한 후보를 초기 선별에서 얼마나 남겼는지를 기준으로 본 품질은 유사했다고 보고했습니다.
Jev Router가 요청을 처리할 모델을 선택한다면, Jack & Jill은 어떤 후보에게 상세 검토를 집중할지 결정합니다.
날씨를 물었는데, 어느 도시인지는 누가 정했을까?
판단 모델을 배치할 수 있는 또 다른 지점은 도구 실행 직전입니다.
사용자: “오늘 날씨 어때?”
에이전트가 하려는 일: 서울의 날씨 조회
사용자: “나 부산인데?”
아래에서 소개할 공식 데모의 상황을 이해하기 쉽게 재구성한 예시입니다.
날씨 조회는 성공하더라도, 사용자가 궁금했던 날씨는 아닙니다. 도구를 제대로 호출하는 것과, 지금 그 도구를 호출하는 것이 적절한지는 다른 문제입니다.
AWS Strands 팀은 Strands Decider 2B를 소개하면서 이 상황을 다루는 데모를 공개했습니다. 판단 모델은 대화 내용과 예정된 도구 호출을 읽고 다음을 평가합니다.
- 도구에 전달할 값이 사용자가 제공한 정보에 근거하는가?
- 추가 확인 없이 지금 도구를 호출해도 되는가?
프로그램은 평가 결과를 받아, 에이전트가 사용자에게 도시를 다시 묻도록 흐름을 돌립니다. 판단 모델을 행동 직전의 점검 단계에 넣은 것입니다. Strands 공식 데모 설명
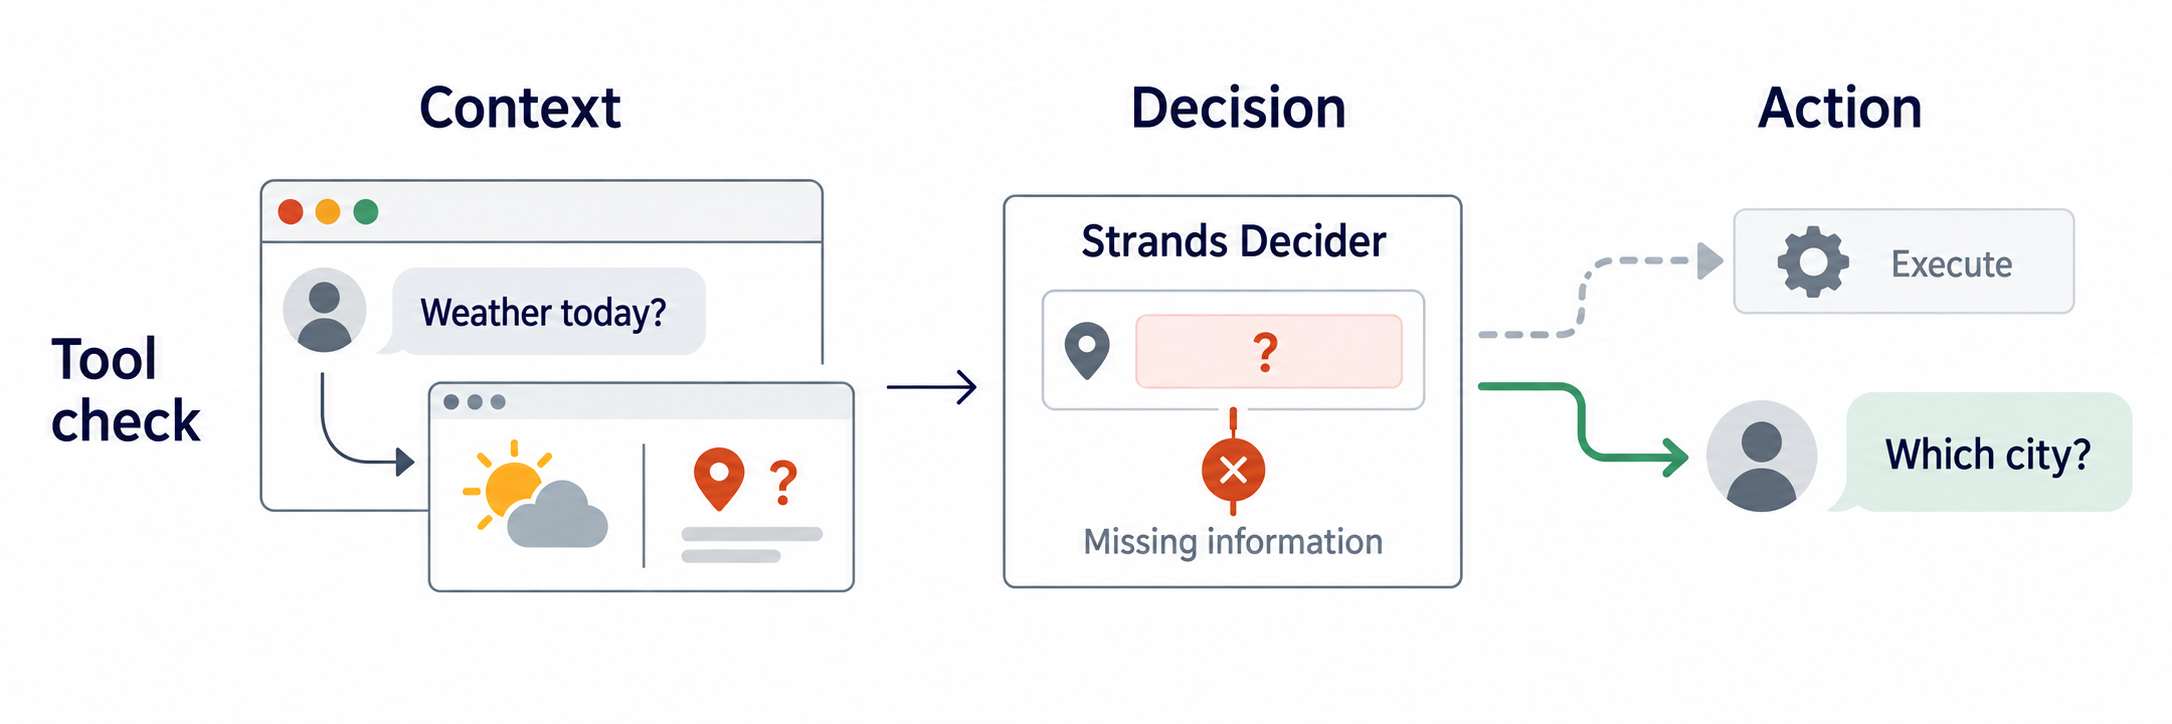
앞의 두 사례가 사용할 모델이나 검토 대상을 골랐다면, 이 데모에서는 준비된 행동을 실행할지, 먼저 정보를 보완할지를 정합니다.
이러한 판단 단계를 구현하는 모델과 API도 짧은 기간에 잇따라 공개되고 있습니다. 2026년 10월 1일, Strands는 공개 판단 모델 Strands Decider 2B를, Cloudflare는 Jev API와 호환되는 Clef를 발표했습니다. Strands · Cloudflare 이어 10월 6일에는 OpenAI가 Decisions API를 베타로 출시했고, 10월 9일에는 Microsoft가 Microsoft-Decision-1을 공개했습니다. OpenAI · Microsoft
불과 열흘도 안 되는 기간에 이어진 발표는 판단 모델에 대한 여러 기업의 관심을 보여줍니다. 개발자는 이러한 모델과 API를 활용해 작업 중 필요한 판단을 맡기고, 그 결과에 따라 LLM이나 도구가 다음에 무엇을 할지 정할 수 있습니다. 판단 모델과 LLM의 역할을 나누고 연결할 수 있는 선택지가 넓어지고 있는 것입니다.
이때 중요한 것은 판단 결과를 다음 행동에 어떻게 연결하느냐입니다. 필요한 후보를 제외하면 상세 검토에서 빠지고, 정보가 부족한 도구 호출을 통과시키면 잘못된 행동으로 이어질 수 있습니다. 그렇다면 어떤 판단은 바로 받아들이고, 어떤 판단은 정보를 보완하거나 다시 검토하도록 해야 할까요?
빠른 판단을 전체 작업의 성과로 연결하려면?
앞의 사례에서 판단 모델은 읽을 문서나 검토할 대상을 골랐습니다. 그런데 관련성이 낮다고 평가한 문서를 나중에 읽는 것과, 아예 읽지 않는 것은 다릅니다. 같은 판단 결과라도 프로그램이 어떻게 사용하느냐에 따라 최종 답변에 미치는 영향이 달라집니다.
‘나중에 읽기’와 ‘읽지 않기’는 어떻게 다를까?
“Jev를 우리 서비스에 활용할 수 있을지 조사해줘”라는 요청을 다시 생각해보겠습니다. 검색 결과 중에는 제목만 보면 관련성이 낮아 보이지만, 본문에 실제 사용 중 발견한 제약이나 실패 사례를 담은 문서가 있을 수 있습니다.
이 문서를 뒤로 미뤄두었다면, 다른 자료를 읽고도 실제 사용의 제약을 파악하지 못했을 때 다시 살펴볼 수 있습니다. 반면 검토 대상에서 제외했다면, 답변을 작성하는 LLM은 그 안에 필요한 정보가 있었다는 사실조차 알지 못합니다.
따라서 관련성이 낮다는 이유만으로 모든 문서를 바로 제외할 필요는 없습니다. 중요한 근거를 놓칠 가능성이 있다면, 애매한 문서는 보류해두고 답변에 필요한 정보가 부족할 때 다시 검토하도록 구성할 수 있습니다.
판단 모델의 결과를 받는 것만큼, 그 결과에 따라 무엇을 남기고 무엇을 제외할지 정하는 일이 중요합니다.
바로 진행하기 어렵다면, 무엇을 더 확인해야 할까?
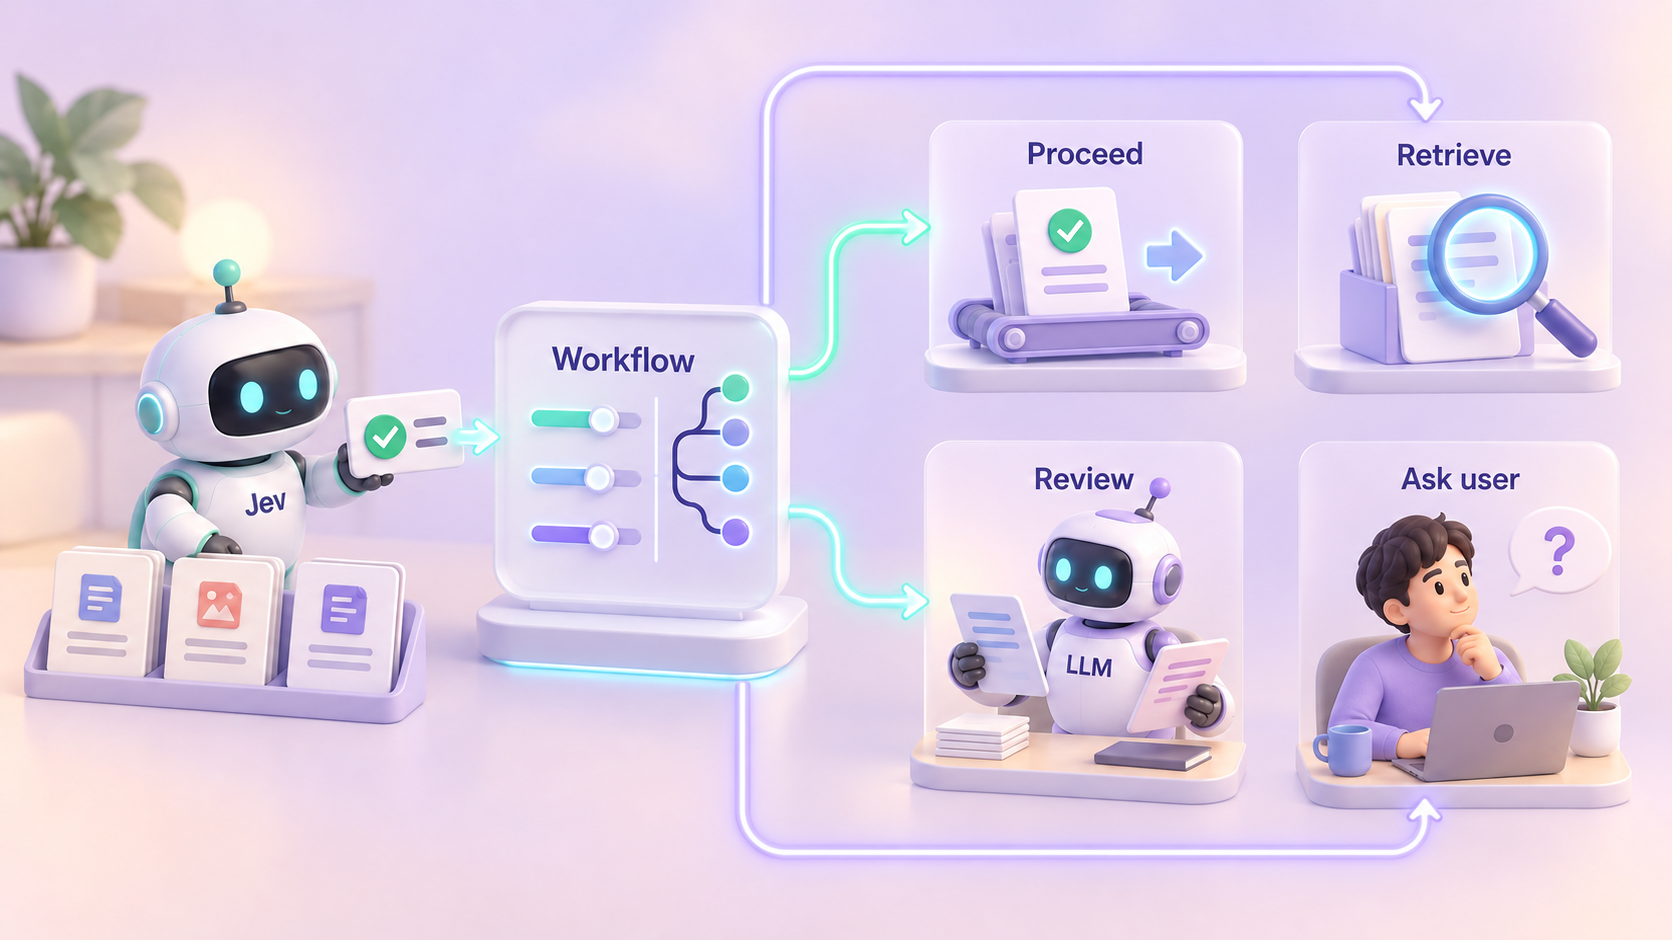
판단 결과만으로 바로 진행하기 어렵다면, 부족한 것이 정보인지, 해석인지, 사용자의 기준인지부터 구분해야 합니다. 이에 따라 자료를 더 찾을지, LLM에 재검토를 맡길지, 사용자에게 확인할지가 달라집니다.
- 정보가 부족하다면 자료를 보완합니다. 기능 소개만으로 실제 서비스에서의 응답 시간이나 비용을 알 수 없다면, 추가 검색이나 직접 평가가 필요합니다.
- 자료의 해석이 어렵다면 더 자세히 검토합니다. 논문마다 평가 지표와 실행 조건이 다르다면, LLM이 차이를 비교하고 결과를 종합하도록 맡길 수 있습니다.
- 사용자의 기준이 필요하다면 직접 확인합니다. 품질을 높이는 대신 비용이 늘어나는 선택이라면, 어느 쪽을 우선할지 사용자에게 물을 수 있습니다.
이처럼 판단 결과에 따라 그대로 진행하거나, 정보를 보완하거나, LLM에 재검토를 맡기거나, 사용자에게 확인하도록 작업 흐름을 구성해야 합니다. 역할 분담은 각 모델의 담당 업무와 함께, 다음 단계로 넘어가는 조건을 정하는 일입니다.
어떤 경우에 다른 모델이나 사람에게 판단을 넘길지는 기존 연구에서도 다뤄졌습니다. NeurIPS 2025에 발표된 Cascaded Language Models for Cost-Effective Human–AI Decision-Making에서는 답변의 신뢰성을 평가해, 그대로 수용하거나 다른 모델이 다시 답하도록 하고, 필요하면 인간 전문가에게 넘기는 구조를 제안했습니다.
역할을 나눈 효과는 어떻게 확인할까?
이렇게 구성한 시스템은 같은 작업을 수행하는 기존 구성과 비교해볼 수 있습니다. SearchJev에서 살펴봤듯, 판단 단계의 변화가 최종 결과에 어떤 영향을 주는지가 중요합니다. 다만 판단 모델을 활용한 효과는 개별 판단의 처리 속도뿐 아니라, 최종 결과의 품질과 전체 시간·비용, 중요한 정보의 누락 여부를 함께 비교해 확인해야 합니다.
- 품질: 최종 답변이나 검토 결과가 유지되거나 개선됐는가?
- 시간·비용: 추가 검색과 재검토까지 포함해 전체 부담이 줄었는가?
- 누락: 중요한 자료나 대상을 놓치는 경우가 늘지 않았는가?
빠른 판단으로 처리 시간을 줄이더라도 필요한 근거를 놓친다면, 전체 작업의 성과가 개선됐다고 보기 어렵습니다.
글을 쓰지 않고 선택하는 AI는 무엇을 바꿀까?
이 글에서 살펴본 판단 모델은 읽을 문서를 고르고, 답변을 맡길 모델을 선택하며, 도구를 실행하기 전에 필요한 정보가 있는지 확인했습니다. 직접 긴 답변을 작성하지 않아도, 다음에 무엇을 읽고 누가 처리하며 어떤 행동을 할지에 영향을 준 것입니다.
Jev와 같은 판단 모델은 빠른 선택·평가와 깊이 있는 검토를 나누어 맡기는 설계의 선택지를 제공합니다. 같은 LLM을 사용하더라도 어떤 자료를 전달하고, 어떤 작업에 검토를 집중하느냐에 따라 답변의 품질과 전체 시간·비용은 달라질 수 있습니다.
따라서 에이전트를 설계할 때는 어떤 모델이 답변할지와 함께, 그 모델에게 무엇을 전달하고 언제 더 생각하게 할지도 정해야 합니다. 글을 쓰지 않고 선택하는 AI는 바로 이 과정에 활용될 수 있습니다.
References
- Almeida, D. (2026). Introducing System One Models & Jev. TypeSafe AI. https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI. Primitives (Questions).https://docs.typesafe.ai/primitives
- Cao, C., Zuo, L., Papakostas, K., Xu, Q., Xu, S., Zhou, L., Ren, Z., Lyu, Y., & Yan, X. (2026). SearchJev: A Fast and Calibrated System-1 Model for Search Agents. arXiv. https://arxiv.org/abs/2610.05107
- Chen, Z., Ma, X., Zhuang, S., Nie, P., Zou, K., Sharifymoghaddam, S., Liu, A., Green, J., Patel, K., Meng, R., Su, M., Li, Y., Hong, H., Shi, X., Liu, X., Oyarhoseini, H., Thakur, N., Zhang, C., Gao, L., Chen, W., & Lin, J. (2026). BrowseComp-Plus: A Fair and Disentangled Evaluation Benchmark for Deep Search Agents. ACL 2026. https://aclanthology.org/2026.acl-long.1023/
- OpenRouter. Jev Router.https://openrouter.ai/docs/guides/routing/routers/jev-router
- TypeSafe AI. (2026). How Jack & Jill Cut Candidate Screening Costs By 88% With Jev.https://typesafe.ai/blog/jack-jill-jev-case-study
- Brooker, M., Chambers, M., & de Paula, F. N. (2026). Introducing Strands Decider 2B: a small, open source, decision model. Strands Agents. https://strandsagents.com/blog/introducing-strands-decider/
- OpenAI. Decisions.https://developers.openai.com/api/docs/guides/decisions
- Chen, M., Reneau, A., & Flansburg, K. (2026). Introducing Clef: our open-source decision models, and new RL fine-tuning platform. Cloudflare. https://blog.cloudflare.com/clef-decision-models/
- Srivastava, A. (2026). Introducing Microsoft-Decision-1, our model for fast decision-making. Microsoft. https://commandline.microsoft.com/microsoft-decision-1-model-foundry/
- Fanconi, C., & van der Schaar, M. (2025). Cascaded Language Models for Cost-Effective Human–AI Decision-Making. NeurIPS 2025. https://proceedings.neurips.cc/paper_files/paper/2025/hash/10e0c427408ccc6e073d9464e2280f89-Abstract-Conference.html